ResNet, 깊이를 다루는 법
들어가며: 더 깊은 모델이 훈련도 더 못한다면
신경망에 층을 더 쌓으면 더 풍부한 표현을 얻을 수 있을 것 같다. 그러나 깊이가 늘어난다고 학습까지 잘되는 것은 아니다. 어떤 실험에서는 더 깊은 모델이 테스트 데이터뿐 아니라 훈련 데이터에서도 더 높은 오류를 보였다.
ResNet의 중심 아이디어는 입력을 매번 새로 만드는 대신, 입력을 전달하는 경로와 변화를 계산하는 경로를 함께 두는 것이다.
1. 기울기 소실·성능 저하·과적합을 구별하기
과적합은 훈련 데이터에는 잘 맞추면서 새로운 데이터에서는 성능이 나빠지는 현상이다. 모델의 훈련 오류는 더 낮아졌는데 테스트 오류가 올라갔다면 전형적인 신호다. 반면 ResNet 논문이 강조한 degradation problem은 깊이를 늘렸더니 훈련 오류부터 높아지는 현상이다. 테스트 성능의 나쁨 이전에, 좋은 해를 찾는 최적화가 어려워졌다는 단서다.
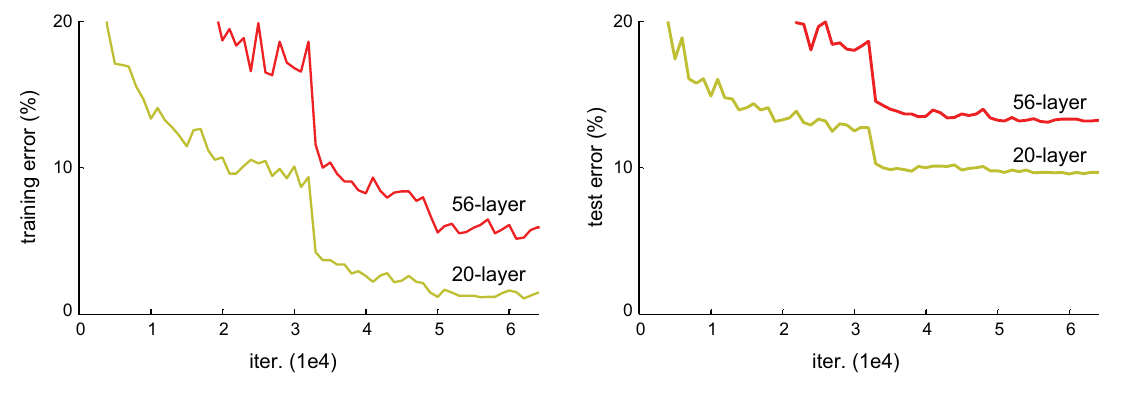
왼쪽이 훈련 오류이고 오른쪽이 테스트 오류다. 가로축은 10,000회 단위의 학습 iteration, 세로축은 오류율이다. 먼저 왼쪽을 읽어야 한다. 56층 모델이 더 높은 훈련 오류를 보인다는 사실이 이 현상을 단순한 과적합으로 설명하기 어렵게 만든다.
기울기 소실은 역전파 도중 미분의 반복 곱으로 기울기가 작아지는 메커니즘이다. degradation은 관찰된 성능 현상이다. 둘은 관련될 수 있지만 동의어가 아니다. 원 논문은 정규화와 적절한 초기화로 소실·폭발을 완화한 뒤에도 깊은 일반 네트워크의 최적화 문제가 남는다는 데 주목했다. Deep Residual Learning for Image Recognition
진단 순서를 기억하면 실용적이다. 먼저 훈련과 검증 곡선을 함께 보고, 둘 다 나쁜지 아니면 훈련만 좋은지 구분한다. 그다음 기울기·초기화·학습률·데이터와 정규화를 살핀다. 테스트 오류만 보고 모든 실패를 과적합이라고 부르면 해결책도 빗나간다.
2. 왜 깊은 모델이 얕은 모델보다 못하면 이상한가
얕은 네트워크에 좋은 해가 있다고 하자. 더 깊은 네트워크가 기존 계산을 그대로 포함하고, 추가 부분이 항등함수처럼 동작할 수 있다면, 적어도 얕은 모델과 같은 결과를 표현할 가능성은 있다. 그런데 학습 알고리즘이 그 해를 찾아 주는 것은 별개의 문제다.
일반적인 층 묶음에는 ‘아무 변화도 하지 않기’가 반드시 쉬운 파라미터 설정으로 주어지지 않는다. 합성곱과 비선형 변환을 여러 번 거친 뒤 입력을 똑같이 재현하도록 학습해야 할 수도 있다. ResNet은 이 출발점을 바꾼다. 항등 경로를 구조로 제공하고, 학습되는 쪽에는 추가할 변화만 맡긴다.
원하는 함수를 H(x)라고 하면 잔차 함수는 F(x) = H(x) − x다. 그러면 결과를 다음처럼 표현할 수 있다.
y = x + F(x)
x는 블록에 들어오는 특징 표현이고, F(x)는 학습되는 잔차다. 여기서 residual은 정답과 예측의 차이인 손실값을 뜻하지 않는다. 입력을 기준으로 함수가 만들어 내는 변화라는 뜻이다.
3. 잔차 블록을 순전파와 역전파로 읽기
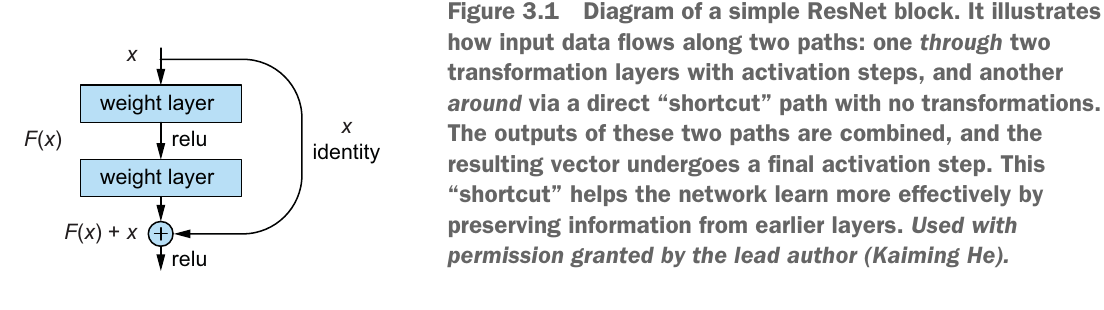
순전파에서 입력은 두 경로로 나뉜다. 하나는 학습되는 층들을 지나 F(x)가 되고, 다른 하나는 그대로 전달된다. 두 결과는 이어 붙이기(concatenation)가 아니라 같은 위치의 값을 더하는 element-wise addition으로 합쳐진다.
스칼라 예를 들면 입력이 10이고 원하는 출력이 10.3일 때 잔차 경로는 0.3을 만드는 문제를 학습한다. 변화가 필요 없으면 F(x)를 0에 가깝게 만들면 된다. 다만 이 비유를 ‘모든 잔차는 반드시 작다’는 제약으로 받아들이면 안 된다. 필요한 경우 큰 변화도 학습할 수 있다.
또한 위 그림의 원래 ResNet 블록에는 합친 뒤 ReLU가 있다. 따라서 정확히는 y = ReLU(x + F(x))다. F(x)=0일 때 음수까지 포함한 모든 x가 그대로 통과한다는 설명은 이 post-activation 블록에 무조건 성립하지 않는다. 이 차이가 뒤의 ResNet v2로 이어진다.
합친 뒤 활성화가 없는 단순한 잔차 블록을 미분하면 다음과 같다. I는 항등행렬이다.
∂y/∂x = I + ∂F/∂x
일반적인 연쇄 경로에 더해 직접 전달되는 항이 생긴다. 여러 블록을 거슬러 갈 때 학습된 변환만 계속 통과해야 하는 부담을 덜 수 있다. 항등 경로는 정보가 앞으로 가는 데에도, 손실의 피드백이 뒤로 가는 데에도 도움이 된다.
하지만 식에 I가 있다고 기울기가 항상 일정하거나 절대 사라지지 않는 것은 아니다. 잔차 쪽 미분과의 상호작용, 활성화, projection, 깊이와 초기화가 여전히 영향을 준다. 좋은 전달 경로가 생겨 최적화가 쉬워진다는 설명과 모든 학습 실패가 사라진다는 주장은 다르다.
두 경로의 크기가 다르면 어떻게 더하나
입력이 56×56×64이고 잔차 출력이 28×28×128이면 그대로 더할 수 없다. 공간 크기와 채널 수를 맞추는 projection shortcut 등을 사용해야 한다. 1×1 합성곱과 stride로 경로를 맞추는 방식이 대표적이다.
y = Wₛx + F(x)
Wₛ는 형태를 맞추는 학습 가능한 변환이다. 이것은 순수한 identity shortcut과 구별된다. ‘ResNet의 모든 지름길은 파라미터가 없다’는 표현은 틀리다. 크기가 같은 블록에서는 항등 경로를 쓸 수 있고, stage를 바꾸는 블록 등에서는 별도 처리가 필요하다.
4. 깊이를 늘려도 비용을 감당하게 만든 bottleneck
잔차 연결이 깊은 학습을 돕는다고 해서 계산 비용까지 자동으로 줄여 주는 것은 아니다. 덧셈을 추가하는 것만으로 모든 합성곱이 싸지는 않기 때문이다. 깊은 ResNet이 비용을 관리한 핵심에는 bottleneck 블록과 전체 구조 설계가 있다.
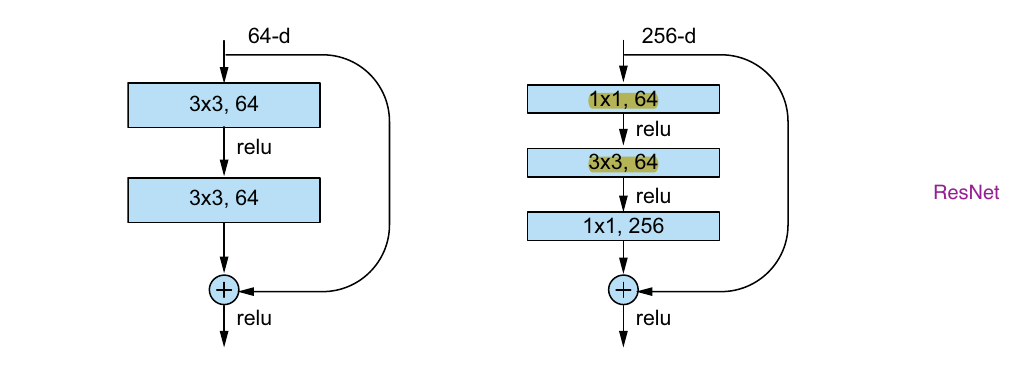
왼쪽 basic block은 3×3 합성곱 두 개를 사용한다. 오른쪽 bottleneck은 먼저 1×1 합성곱으로 채널을 줄이고, 적은 채널에서 비용이 큰 3×3 연산을 한 뒤, 다시 1×1 합성곱으로 채널을 늘린다. 1×1 합성곱은 공간의 주변을 함께 보는 대신 같은 위치의 채널들을 섞는 학습 가능한 변환이다.
숫자로 보면 기억하기 쉽다. 공간 크기가 같고 bias·정규화·shortcut을 제외한다고 하자. 256채널을 유지하는 3×3 합성곱 하나는 3×3×256×256 = 589,824개의 가중치를 갖는다. 256 → 64 → 64 → 256 bottleneck의 세 합성곱은 각각 16,384개, 36,864개, 16,384개로 합계 69,632개다. 이것은 비용 직관을 위한 예시이지 두 네트워크의 정확도나 표현력이 같다는 비교가 아니다.
채널을 줄였다가 늘린다고 이전 정보를 손실 없이 복구하는 압축 해제기가 되는 것도 아니다. 잔차 가지는 더 적은 비용으로 유용한 변환을 계산하고, shortcut은 별도의 경로를 제공한다. 깊은 구조의 비용과 정보 전달을 나누어 설계하는 것이다.
AlexNet은 비교적 큰 초기 필터와 완전연결 층을 사용했고, VGG는 작은 3×3 합성곱을 반복했으며, GoogLeNet은 여러 크기의 연산을 병렬 가지로 묶었다. ResNet이 이들 뒤에 덧붙인 핵심 질문은 ‘어떤 특징 추출기를 쓸 것인가’에 더해 ‘많은 변환을 어떻게 학습 가능한 경로로 연결할 것인가’였다.
5. ResNet v2: 더한 뒤에도 지름길이 열려 있는가
원래 블록의 shortcut은 입력을 그대로 전달하지만, 합쳐진 뒤의 ReLU는 그 결과를 다시 바꾼다. 한두 블록에서는 사소해 보이는 선택이 수백 블록에 걸쳐 반복되면 정보와 기울기의 전달에 영향을 줄 수 있다.
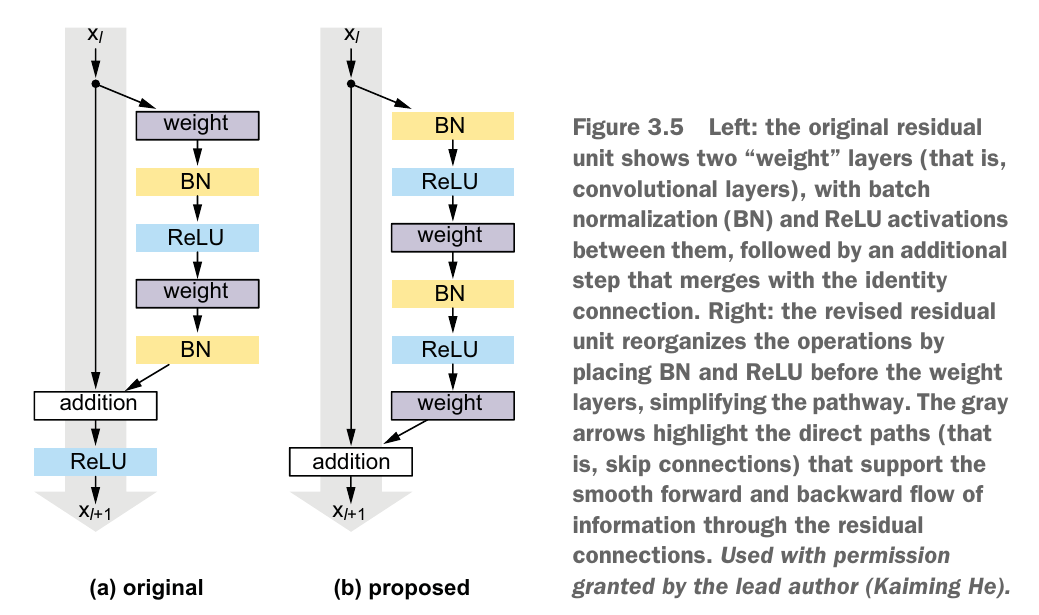
왼쪽의 전형적인 v1 블록은 합성곱 → BN → ReLU → 합성곱 → BN을 지난 뒤 shortcut과 더하고 ReLU를 적용한다. 오른쪽의 full pre-activation 블록은 BN과 ReLU를 각 합성곱 앞에 두고, 두 경로를 더한 뒤에는 활성화를 넣지 않는다. BN은 batch normalization으로, 학습 중 미니배치 통계에 따라 활성값을 정규화하고 학습 가능한 크기·이동 변환을 적용한다.
이 배치에서는 같은 크기의 블록 사이를 xₗ₊₁ = xₗ + Fₗ(xₗ)로 볼 수 있다. 여러 블록에 대해 펼치면 초기 표현에 잔차들이 더해지는 형태가 나타난다. 항등 경로를 매번 비선형 함수로 변형하지 않는 것이 요점이다. Identity Mappings in Deep Residual Networks
논문의 ablation은 ‘복잡하게 만들면 더 좋을 것’이라는 추측을 실제로 시험한다. shortcut에 상수 배율, 게이트, dropout, 변환 등을 추가했을 때 순수한 항등 경로보다 학습이 어려워지는 실험 결과가 나왔다. 원리를 설명하는 간단한 예는 0.5 배율이다. 직접 경로가 블록마다 절반으로 줄면 20개 뒤에는 0.5의 20제곱이 된다. 잔차 가지 전체를 무시한 직관적 예시지만, 직접 경로를 보존하는 이유를 잘 드러낸다.
이 결과를 ‘게이트나 projection은 언제나 나쁘다’로 일반화하면 안 된다. shape를 바꾸는 projection은 필요할 수 있고, LSTM은 게이트를 핵심으로 쓴다. 해당 실험은 특정 잔차 네트워크에서 불필요하게 항등 경로를 건드리는 비용을 보여 준다.
깊이를 더 많이 쌓았다고 항상 일반화가 좋아지는 것도 아니다. 원래 ResNet의 1,202층 CIFAR-10 실험은 학습 가능성과 일반화가 다른 문제임을 드러냈다. 후속 pre-activation 연구의 1,001층 결과와 비교할 때도 구조와 실험 설정을 함께 봐야 한다. ‘천 층이면 백 층보다 좋다’는 법칙을 얻은 것이 아니다.
6. 분류에서 분할로: 넓게 보면서 위치를 남기기
이미지 분류는 사진 전체에 하나의 범주를 붙인다. semantic segmentation은 각 픽셀에 도로·차·사람 같은 범주를 붙인다. 분류에서는 어느 정도 위치 정보를 줄여도 정답을 맞힐 수 있지만, 분할에서는 경계의 정확한 위치가 중요하다.
다운샘플링은 계산을 줄이고 넓은 맥락을 보는 데 유리하다. 그러나 작은 물체와 경계 정보를 잃을 수 있다. 큰 커널로 넓게 보는 대안은 파라미터가 늘어난다. Dilated convolution은 커널의 학습값 개수를 유지하면서 샘플을 읽는 간격을 벌리는 방법이다.
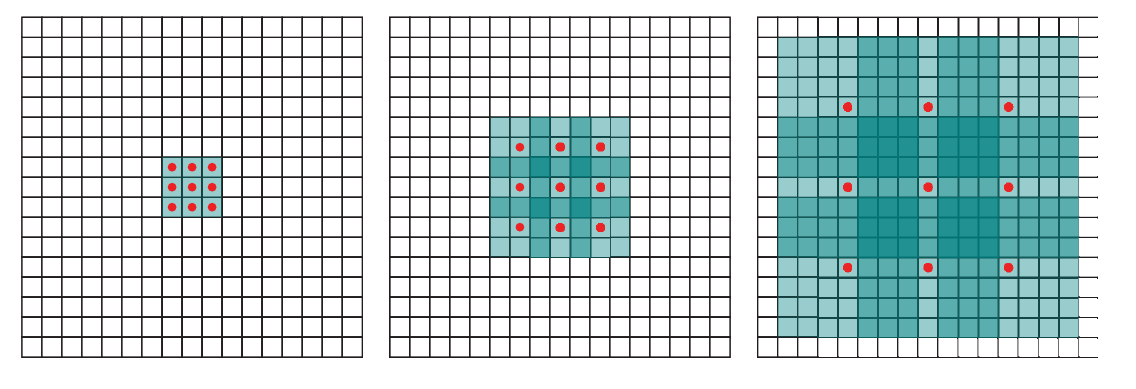
커널 크기를 k, dilation을 d라고 할 때 한 층의 유효 커널 폭은 다음과 같다.
k_eff = 1 + (k − 1)d
3×3 커널에서 d=1이면 3×3 범위, d=2이면 5×5 범위, d=4이면 9×9 범위의 위치를 샘플링한다. 어느 경우에도 입력·출력 채널 한 쌍의 학습 가중치는 아홉 개다. 9×9 위치를 모두 읽는 일반 커널과 같지는 않다.
그림을 층을 쌓은 수용 영역으로 읽으면 숫자가 달라진다. stride 1인 3×3 층을 dilation 1, 2, 4 순서로 쌓을 때 누적 수용 영역의 폭은 3, 7, 15가 된다. ‘한 층의 유효 폭’과 ‘여러 층을 통과한 누적 범위’를 구분해야 한다. 간격을 두 배씩 늘리는 구성이기 때문에 누적 범위가 빠르게 커지는 것이지, dilation의 값에 대해 단일 층의 폭이 지수적으로 증가하는 것은 아니다.
stride 1과 적절한 padding을 사용하면 출력 해상도를 유지할 수 있다. 다만 높은 해상도의 특징 맵은 메모리와 연산 비용이 든다. 같은 해상도·채널의 일반 3×3 합성곱과 파라미터 수가 같다는 말이, 다운샘플링하는 네트워크와 전체 비용까지 같다는 말은 아니다.
책은 이 연구를 ResNet과 연결하지만, Yu와 Koltun의 논문은 ResNet의 단순한 후속 버전이 아니다. VGG 기반의 분할 구조와 context module을 다룬 별도 연구다. 일부 모듈의 identity 초기화도 구조적으로 shortcut을 계속 제공하는 ResNet과 구별해야 한다. 하나는 출발 가중치의 선택이고, 다른 하나는 학습 내내 존재하는 경로다. Dilated Convolutions 논문
7. 인간 수준이라는 말보다 평가 조건을 기억하기
ResNet의 대표 대회 결과로 자주 인용되는 3.57%는 ILSVRC 2015 앙상블의 top-5 오류율이다. 단일 모델, 다른 crop 평가, 검증 세트의 수치와 섞으면 비교가 틀어진다. 좋은 수치는 반드시 어떤 데이터·척도·모델 조합에서 측정되었는지를 붙여 기억해야 한다.
당시 인간 성능과 비교한 이야기도 같은 원칙으로 읽는다. 특정 이미지 범주와 제한된 주석자 실험에서 얻은 기준을 넘었다고 인간의 시각 능력 전반을 넘었다고 말할 수는 없다. 세부 개 품종을 구분하는 능력, 낯선 장면에서 상식적으로 추론하는 능력, 변형된 이미지에 견디는 능력은 같은 평가가 아니다.
특히 모델의 top-1 정확도를 인간의 top-5 정확도와 직접 비교하면 척도 자체가 다르다. ‘인간보다 잘한다’는 문장에 동의하거나 반대하기 전에 같은 조건의 비교인지 확인해야 한다.
8. CS231n과 ‘무엇을 확장할 것인가’
책이 CS231n을 함께 다루는 이유는 기술의 확산도 진전의 일부이기 때문이다. 강의와 실습은 합성곱, 역전파, 정규화, 실제 훈련의 연결을 다른 사람도 재현할 수 있게 했다. 논문의 결론을 아는 것과 손실 곡선을 보고 학습 실패를 진단하는 것은 다른 수준의 이해다.
잔차 연결은 데이터와 GPU를 대체하지 않는다. 같은 자원이 더 깊은 표현 학습에 쓰이도록 최적화의 병목을 완화한다. 늘리는 대상이 깊이인지 너비인지, 데이터인지 학습 시간인지 먼저 밝히고, 그 자원이 어떤 경로로 성능을 개선할지 물어야 한다.
복습: 이 식과 그림을 다시 설명할 수 있는가
degradation은 과적합과 어떻게 다른가? 더 깊은 모델의 훈련 오류부터 높아진다는 점이 핵심이다. 검증 오류만 높은 과적합과 구별한다.
F(x)=0이면 무엇이 남는가? 순수한 잔차 덧셈에서는 x가 남는다. 단, 합친 뒤 ReLU가 있는 v1과 shape를 바꾸는 projection의 조건은 별도로 봐야 한다.
기울기 식의 I는 무엇을 뜻하는가? 학습된 잔차 변환을 거치지 않는 직접 미분 경로다. 기울기 문제를 무조건 해결한다는 뜻은 아니다.
bottleneck의 계산량을 줄이는 부분은? 비싼 3×3 합성곱을 적은 채널에서 수행하는 부분이다. 잔차 덧셈 자체가 비용 절감의 원인은 아니다.
pre-activation이 바꾼 것은? 정규화와 활성화를 잔차 가지의 합성곱 앞으로 옮기고, 더한 뒤의 활성화를 없애 블록 사이 항등 경로를 보존했다.
dilation과 stride는 어떻게 다른가? dilation은 커널 안에서 샘플을 읽는 간격, stride는 출력 위치 사이에서 커널이 이동하는 간격이다. 전자는 해상도를 유지하며 수용 영역을 넓힐 수 있고, 후자는 흔히 해상도를 줄인다.