RNN에서 Deep Speech 2까지, 기억을 학습하고 확장하는 법
들어가며: 순서가 있는 데이터의 학습
문장, 음성, 시계열은 현재 입력만으로 답하기 어렵다. 앞에서 무엇이 나왔는지가 지금의 해석을 바꾸기 때문이다.
1. RNN의 핵심은 예측값이 아니라 상태를 전달하는 것이다
‘나는 프랑스에서 자랐다. … 그래서 프랑스어를 할 수 있다’에서 뒷부분을 예측하려면 앞의 나라 정보가 도움이 된다. 가까운 몇 단어만 보는 모델은 중간 문장이 길어지면 이 단서를 놓친다.
n-gram 언어 모델은 보통 앞의 n−1개 토큰으로 다음 토큰의 확률을 추정한다. RNN(recurrent neural network)은 이전 입력을 요약한 hidden state를 갱신하면서 문맥을 전달한다. 가장 단순한 RNN을 쓰면 다음과 같다.
hₜ = tanh(Wₓxₜ + Wₕhₜ₋₁ + b)
pₜ = softmax(Wᵧhₜ + bᵧ)
xₜ는 현재 입력 벡터, hₜ₋₁은 이전 상태, hₜ는 갱신된 상태다. 언어 모델이라면 pₜ를 다음 토큰의 분포로 해석할 수 있다. 시점마다 별도의 모델을 사용하는 것이 아니라 같은 Wₓ·Wₕ 등의 파라미터를 반복 사용한다.
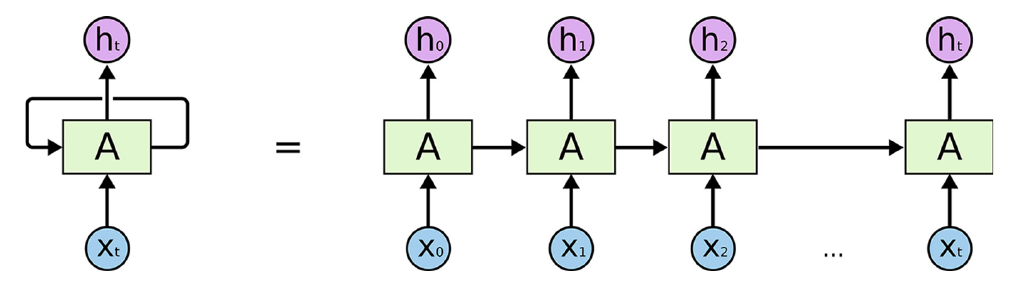
왼쪽의 고리는 오른쪽처럼 시간축으로 펼쳐 읽는다. 위로 나가는 출력과 옆으로 전달되는 상태를 구별하는 것이 중요하다. 다음 시점의 내부 계산에 전달되는 것은 단순히 ‘직전에 예측한 단어’가 아니라 상태 벡터다. 생성에서는 직전에 선택한 토큰도 다음 입력으로 넣지만, 그것과 내부 상태의 전달은 서로 다른 연결이다.
RNN은 고정된 차원의 상태를 통해 임의 길이의 입력을 처리할 수 있다. 그렇다고 길이에 제한 없이 모든 과거를 정확히 기억하는 것은 아니다. 이전 정보가 상태에 유용하게 남고, 학습이 그 정보를 유지하도록 성공했을 때만 먼 문맥을 활용할 수 있다. ‘원리상 의존할 수 있음’과 ‘실제로 학습함’을 구별해야 한다.
2. Karpathy의 문자 생성 실험에서 배울 것
Karpathy의 The Unreasonable Effectiveness of Recurrent Neural Networks는 문자 단위 모델이 글, 코드, 문서 형식 등을 만들어 내는 예시를 보여 준다. 문자 단위라는 점이 중요하다. 단어 사전이나 문법 규칙을 처음부터 제공하지 않아도, 연속된 문자를 예측하는 과정에서 공백, 단어 형태, 문장 부호 같은 규칙성을 배울 수 있다.
학습할 때는 실제 문자열을 한 칸 밀어 입력과 정답을 만든다. 예를 들어 ‘hello’의 일부라면 h 다음 e, e 다음 l, l 다음 l, l 다음 o가 정답이 된다. 정답의 확률을 높이는 교차 엔트로피 손실을 여러 시점에 걸쳐 줄인다. 생성할 때는 정답 문자를 받아 이어 가는 대신, 모델이 선택한 문자를 다시 입력해 다음 문자를 만든다. 한 번의 실수가 이후 문맥에도 영향을 줄 수 있다.
temperature는 이때 확률 분포를 조절한다. logit zᵢ에 대해 exp(zᵢ/T)를 정규화하면 T가 작을수록 높은 점수의 후보에 확률이 집중되고, T가 클수록 분포가 평평해진다. 새로운 지식을 학습시키는 장치가 아니라 출력 선택의 무작위성을 바꾸는 장치다. 온도를 올린다고 내용이 더 정확해지거나 생각이 깊어지는 것은 아니다.
문자 모델은 짧은 형식과 문체를 흉내 내면서도 긴 문맥에서 모순을 만들 수 있다. LaTeX에서 proof를 열고 lemma로 닫는 식의 오류는 그럴듯한 표면과 장기적인 일관성이 다르다는 예다. 이 결과를 제대로 평가하려면 재미있는 샘플뿐 아니라 테스트 손실과 간단한 n-gram 기준선도 비교해야 한다.
특정 셀이 따옴표 내부나 들여쓰기 같은 패턴에 반응하는 시각화는 내부 표현을 탐색할 단서다. 하지만 한 셀의 반응만으로 모델 전체가 그 개념을 인간처럼 이해한다고 결론낼 수는 없다. 재현 가능한 실험을 널리 열어 주었다는 점이 이 블로그의 중요한 기여다.
3. BPTT: 시간을 펼치면 깊은 네트워크가 된다
RNN의 학습은 backpropagation through time(BPTT), 즉 시간을 따라 펼친 그래프에서의 역전파다. 100시점 뒤의 오류가 첫 시점의 상태에 어떻게 의존하는지 계산하려면 중간 상태 전이의 미분을 거슬러 곱해야 한다.
각 전이의 Jacobian을 Jₜ라고 하면 먼 과거에 대한 미분에는 Jₜ, Jₜ₋₁, …의 곱이 들어간다. 단순 RNN에서는 가중치 Wₕ와 tanh의 미분이 반복적으로 관여한다. 곱의 크기가 줄면 먼 과거의 학습 신호가 약해지고, 커지면 갱신이 폭주할 수 있다. 같은 상태 전이가 시간축에서 반복되기 때문에, 긴 시퀀스에서는 이 곱셈이 더 많이 누적된다.
Gradient clipping은 기울기 벡터의 norm이 기준을 넘으면 크기를 줄이는 방법이다. 방향을 유지하면서 지나치게 큰 한 번의 업데이트를 막을 수 있다. 그러나 이미 0에 가까워진 먼 과거의 기울기를 되살리지는 않는다. 폭발을 제어하는 방법과 기억 경로를 개선하는 방법은 구별해야 한다.
실제 학습에서는 계산과 메모리 때문에 일정 길이에서 역전파를 끊는 truncated BPTT를 사용하기도 한다. 상태 값을 다음 구간으로 이어 갈 수 있어도, 이전 구간으로 전달되는 기울기 그래프는 끊긴다. 이 역시 ‘상태가 이어진다’와 ‘아무리 먼 시점까지 학습 신호가 돌아간다’가 다르다는 예다.
4. LSTM을 두 상태와 세 게이트로 다시 조립하기
LSTM은 RNN 계열의 한 구조다. 흔히 쓰는 현대적 LSTM에는 cell state cₜ와 hidden state hₜ가 있다. cₜ는 비교적 직접적으로 정보를 전달하는 경로이고, hₜ는 현재 시점에서 드러내 다음 계산에 사용할 표현이다. ‘장기 기억’과 ‘단기 기억’이라는 비유는 유용하지만 정해진 보존 시간을 가진 두 개의 저장소는 아니다.
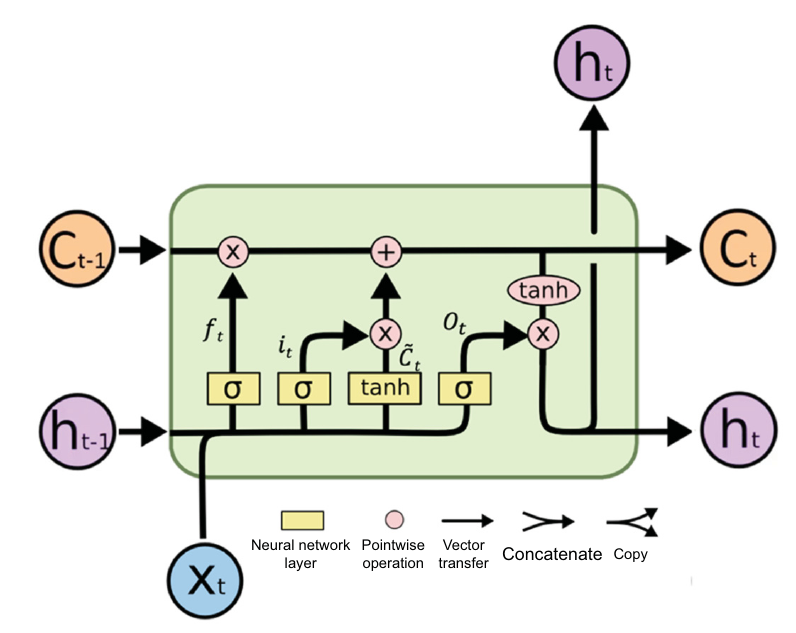
그림 위의 긴 가로 경로가 c의 이동이다. 원 안의 ×는 같은 차원끼리 곱하는 element-wise multiplication, +는 더하기다. σ 블록은 sigmoid를 뜻한다. 그림을 모두 외우기보다 ‘이전 기억을 얼마나 남길까 → 무엇을 추가할까 → 무엇을 밖으로 보여 줄까’의 순서로 읽으면 된다. 원 설명은 Understanding LSTM Networks다.
4.1 게이트들이 보는 입력
현재 입력 xₜ와 이전 hidden state hₜ₋₁을 이어 붙인 벡터를 uₜ라고 하자. 서로 다른 가중치 행렬이 같은 uₜ를 보고 각기 다른 값을 계산한다.
uₜ = [hₜ₋₁, xₜ]
fₜ = σ(Wfuₜ + bf)
iₜ = σ(Wiuₜ + bi)
gₜ = tanh(Wguₜ + bg)
oₜ = σ(Wouₜ + bo)
f는 forget gate, i는 input gate, o는 output gate다. g는 기억에 추가할 후보 내용이다. g까지 포함해 네 묶음의 학습 변환이 있지만, 모두가 게이트인 것은 아니다. 여기서 사용하는 LSTM은 forget gate를 포함한 표준적인 설명이며 1997년 최초 제안의 도식과 완전히 동일하지는 않다.
4.2 이전 기억을 남기고 새 내용을 더하기
cₜ = fₜ ⊙ cₜ₋₁ + iₜ ⊙ gₜ
⊙는 같은 위치의 원소끼리 곱한다는 표시다. fₜ는 기존 기억의 각 성분을 얼마나 유지할지 정한다. iₜ는 새 후보를 얼마나 써 넣을지 정한다. gₜ는 추가할 내용 자체다. 기존 기억을 통째로 덮어쓰지 않고 유지할 부분과 갱신할 부분을 학습할 수 있다.
한 성분만 예로 들어 보자. cₜ₋₁=0.8, fₜ=0.9, iₜ=0.2, gₜ=−0.5라면 새 값은 0.9×0.8 + 0.2×(−0.5) = 0.62다. 기존 정보는 일부 남고 새 정보가 반대 방향으로 조금 수정한 셈이다. 실제 모델에서는 이 계산이 많은 차원에서 동시에 일어나며, 한 차원이 사람이 이름 붙인 사실 하나에 대응한다고 보장되지 않는다.
4.3 기억 중 지금 드러낼 부분 선택하기
hₜ = oₜ ⊙ tanh(cₜ)
셀 상태가 곧바로 최종 단어나 문자가 되는 것이 아니다. output gate가 조절한 hₜ를 다음 시점과 다음 층에 전달하고, 별도의 출력 층이 단어 등의 점수를 계산한다. 정보를 기억 속에 남겨 두면서 지금의 출력에는 덜 반영하는 선택이 가능하다.
sigmoid가 0~1 사이 값을 내는 것은 통과 비율로 쓰기 좋기 때문이다. tanh가 −1~1 사이 값을 내는 것은 후보 내용에 양수와 음수 방향을 허용한다. 따라서 ‘sigmoid와 tanh는 기울기를 줄이니 LSTM에서도 없애야 한다’고 외우면 구조를 놓친다. 중요한 것은 활성화 이름뿐 아니라 어디에 배치되고 어떤 경로를 제어하는가다.
5. LSTM과 ResNet은 어디가 비슷하고 다른가
ResNet의 단순한 잔차 식은 x 다음에 F(x)를 더한다. LSTM의 셀 상태 식도 유지할 기존 정보와 새 정보를 더한다. 둘 다 매 단계 전체 정보를 비선형 변환으로 다시 만들기만 하는 구조에서 벗어나, 정보를 전달할 직접적인 경로를 마련한다는 공통점이 있다.
차이는 LSTM의 직접 경로에 forget gate가 있다는 것이다. 게이트 값을 고정해서 직접 셀 경로만 보면 cₜ를 cₜ₋₁로 미분한 값은 fₜ다. 여러 시점을 거치면 해당 게이트들의 곱이 기억과 기울기의 유지에 영향을 준다. 전체 미분에는 h와 게이트를 통해 우회하는 의존성도 있으므로 이 식은 전체 시스템의 미분을 모두 나타내는 것은 아니다.
f가 1에 가깝고 새 쓰기가 작으면 정보를 오래 보존하기 유리하다. 그러나 f=0.9가 100번 반복되면 약 0.0000266이다. 1에 가깝다는 말의 효과는 필요한 시간 길이에 따라 달라진다. LSTM은 먼 의존성의 학습을 돕지만 무한 기억이나 완벽한 기울기를 보장하지 않는다.
따라서 ResNet의 항등 경로와 LSTM의 gated memory를 같은 장치라고 부르기보다, 보존할 경로와 수정할 경로를 분리한다는 설계 관점을 공유한다고 이해하는 편이 정확하다.
6. 큰 RNN이 과적합할 때: dropout을 어디에 둘 것인가
기억 구조를 개선해도 일반화 문제는 남는다. 큰 LSTM이 훈련 문장을 잘 맞히면서 새 문장의 확률을 나쁘게 추정할 수 있다. AlexNet에서 효과적이었던 dropout을 그대로 모든 연결에 적용하면 어떨까?
문제는 시간축이다. 과거 정보를 계속 전달하는 recurrent 경로에 시점마다 새로운 무작위 마스크를 씌우면, 기억이 반복해서 교란된다. 정규화가 과적합을 줄이는 대신 장기 정보를 유지해야 하는 계산 자체를 방해할 수 있다.
Zaremba·Sutskever·Vinyals의 처방은 비순환 연결에 dropout을 적용하는 것이다. 같은 시점의 층 간 전달, 즉 아래 층의 출력이 위층의 입력이 되는 연결은 정규화하되, 같은 층에서 다음 시점으로 가는 순환 경로는 유지한다. 이 구분을 그림 없이 복원하려면 ‘가로는 시간, 세로는 층’이라고 떠올리면 된다. Recurrent Neural Network Regularization
이 방법은 기울기 소실을 직접 해결하는 새 기억 장치가 아니다. LSTM의 기억 경로를 훼손하지 않으면서 과적합을 줄여 더 큰 모델을 활용하게 하는 학습법이다. 이후에는 다른 형태의 recurrent dropout도 연구되었으므로, ‘순환 연결에는 어떤 dropout도 절대 쓰면 안 된다’는 일반 법칙으로 확대하지 않는다.
Perplexity를 정확히 읽기
Perplexity(PPL)는 정답 토큰에 부여한 확률의 평균 음의 로그를 지수로 되돌린 값이다. 자연로그를 사용하면 다음과 같다.
PPL = exp(−(1/N) Σ log P(xₜ | 앞선 문맥))
네 후보에 항상 같은 확률을 주고 정답이 그 안에 있다면 PPL은 4다. 실제 모델에서는 분포가 시점마다 다르므로 ‘실제로 매번 후보 네 개를 생각한다’는 뜻은 아니다. ‘그 정도 균등한 선택의 불확실성에 해당한다’는 직관이다. 정답에 높은 확률을 주면 낮아지고, 자신 있게 틀리면 커진다.
비교하려면 데이터와 전처리, vocabulary, tokenization이 같아야 한다. 문자 단위와 단어 단위 모델의 PPL을 숫자만으로 비교할 수 없다. 낮은 PPL이 유창성이나 과제 성능과 관련될 수는 있지만 사실성·추론·안전성을 모두 측정하지도 않는다.
책에서 소개한 Penn Treebank 결과에서 큰 dropout LSTM은 테스트 PPL 78.4를 기록한다. 114.5라는 비교 수치와의 차이를 기억할 때는 모델 크기와 훈련 설정이 함께 다르다는 점을 남겨 둬야 한다. dropout 하나만 바꾼 동일 조건 실험의 효과로 단정할 수 없다. 또한 당시 이미 100 이하의 PPL을 낸 혼합 모델이 있었으므로 ‘그전에는 어떤 모델도 100을 넘지 못했다’는 식의 역사는 부정확하다. 이 연구의 의미는 정규화된 단일 LSTM이 강력한 결과를 내며 확장 가능성을 보여 주었다는 데 있다.
7. Deep Speech 2: 음성 인식을 하나의 학습 문제로 만들기
음성 인식은 길이가 서로 다른 두 시퀀스를 연결하는 문제다. 입력에는 수많은 짧은 음향 프레임이 있고, 출력에는 상대적으로 적은 문자나 단어가 있다. 말의 속도와 발음에 따라 같은 문장도 다른 길이의 음성으로 나타난다.
기존 음성 인식 시스템은 음향 모델, 발음 사전, 언어 모델 등 여러 구성 요소를 조합했다. Deep Speech 2(DS2)는 음향 특징에서 문자 계열의 출력으로 이어지는 신경망을 대규모로 학습했다. 음소 단위의 발음 사전을 직접 구성하는 부담을 줄인 것이 의미 있다. 그러나 모든 구성 요소가 하나의 신경망으로 사라졌다고 해석하면 안 된다. 실제 decoding에는 외부 언어 모델도 사용했다.
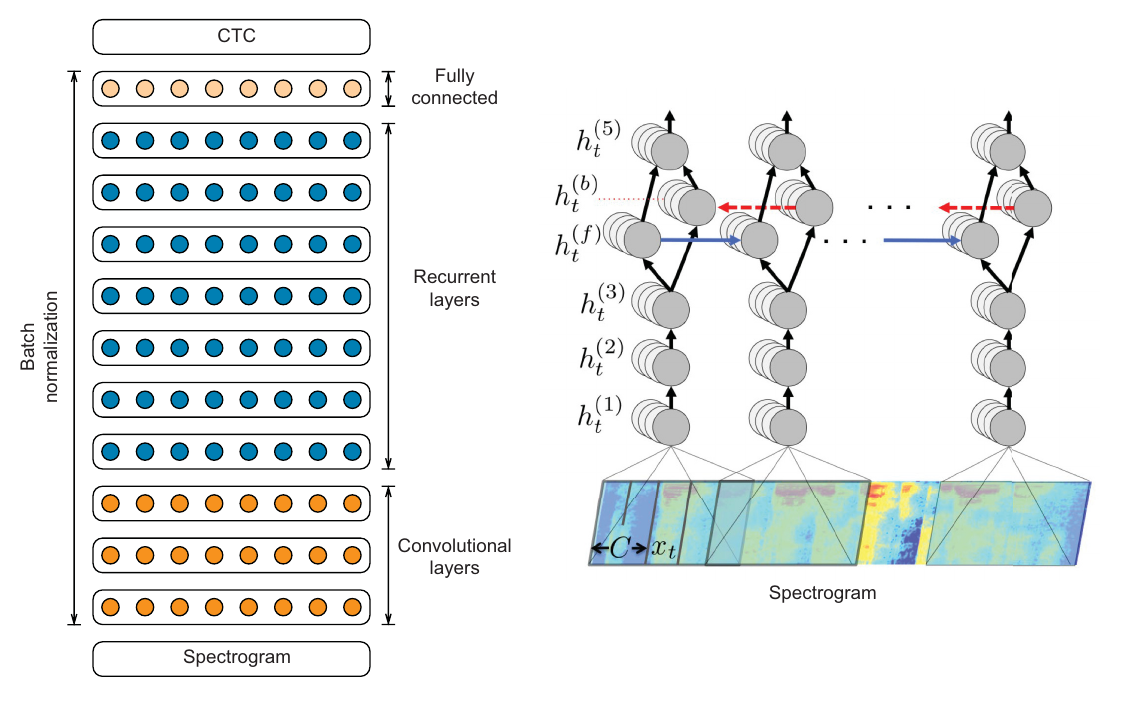
입력 음성을 spectrogram 같은 시간·주파수 표현으로 변환하고, 합성곱 층이 국소적인 음향 패턴을 처리한 뒤, 순환 층들이 시간적 문맥을 모델링한다. 마지막 층은 출력 기호와 blank에 대한 분포를 계산한다. 책은 영어의 문자 bigram 출력과 중국어 문자 출력, 층 수를 바꾼 실험들을 설명한다. 하나의 고정된 층 구성을 모든 DS2 실험의 유일한 모델로 외우기보다, 이런 설계 공간을 비교한 시스템 연구로 읽는 편이 낫다.
DS2의 모든 순환 층이 LSTM인 것은 아니다. RNN은 구조의 큰 범주이고, DS2는 단순 순환 유닛 등 여러 선택을 실험한다.
8. CTC: 정확한 시간표 없이 음성과 문장을 맞추는 법
훈련용 음성과 그 전체 전사문은 있지만, 어느 프레임이 어느 문자에 해당하는지 모른다고 하자. Connectionist Temporal Classification(CTC)은 이 정렬을 하나로 확정한 레이블 없이 학습하게 한다.
CTC의 경로에는 문자 외에 blank라는 추가 기호가 있다. 경로를 전사문으로 바꾸는 축약 연산 B는 연속으로 반복된 같은 기호를 합치고 blank를 제거한다. 예를 들어 아래의 두 프레임 경로는 모두 ‘cat’이 된다. 밑줄은 blank다.
c c _ a a _ t → cat
_ c a _ t t _ → cat
반대로 같은 글자가 실제로 두 번 나오는 경우에는 blank가 구별을 돕는다. ‘ll’을 만들려면 ‘l _ l’처럼 두 l 사이를 분리할 수 있다. ‘l l’만 있으면 하나의 l로 합쳐진다. 반복을 합치는 단계와 blank를 제거하는 단계의 순서를 바꾸면 결과가 달라질 수 있다.
정답 문장을 y, 음향 입력을 x, 한 프레임 경로를 π라고 하면 CTC의 목표는 정답으로 축약되는 모든 경로의 확률을 합치는 것이다.
P(y | x) = Σ[B(π)=y] P(π | x)
각 경로의 확률은 프레임별 출력 확률의 곱으로 모델링하고, 가능한 정렬들의 합은 동적 계획법으로 계산한다. 눈에 보이는 한 경로만 골라 학습하는 것이 아니다. 따라서 ‘정렬이 없어졌다’보다 ‘정렬을 잠재적인 여러 경로로 취급한다’가 더 정확하다.
CTC가 정답 없이 학습한다는 뜻도 아니다. 전체 전사문은 필요하다. 또한 시간 순서를 뒤집지 않는 정렬을 가정하므로, 음성과 전사처럼 순서가 대응하는 문제에 자연스럽다. 임의의 재배열을 자유롭게 해결하는 일반 번역 목적함수는 아니다.
이 설명에서 프레임 출력의 조건부 독립 가정을 들었다고, 신경망이 현재 프레임만 본다고 오해할 수 있다. 프레임별 확률을 내는 신경망 자체는 순환 구조 등으로 주변 문맥을 볼 수 있다. 가정은 출력 경로의 확률을 분해하는 방식에 관한 것이다.
9. 학습 규모를 실제로 키운 선택들
DS2를 기억할 때는 기술 이름을 나열하기보다 어떤 비용을 줄였는지 연결하는 편이 좋다.
시간축 stride와 출력 단위. 앞쪽 합성곱에서 시간 해상도를 줄이면 순환 층이 처리할 단계가 줄어든다. 대신 출력 시점이 부족하면 CTC가 긴 전사문을 정렬하기 어려워진다. 문자 두 개를 하나의 출력 단위로 묶는 영어 bigram은 필요한 출력 길이를 줄이는 선택이다. 그렇다고 음향 프레임 두 개가 문자 두 개에 정확히 대응하는 것은 아니다. CTC의 정렬 여유와 실제 발화 속도를 함께 고려해야 한다.
Sequence-wise batch normalization. 길이가 다른 시퀀스를 다루면서 배치와 시간축의 유효한 활성값을 이용해 정규화한다. padded 영역을 실제 음성처럼 취급하지 않도록 해야 한다. 깊은 순환 모델을 훈련할 때 활성값의 스케일과 최적화 동작을 관리하는 방법이지, 문장마다 의미를 표준화하는 연산이 아니다.
SortaGrad. 첫 epoch에는 짧은 발화부터 학습하고 이후에는 순서를 섞는다. 긴 정렬 문제를 처음부터 한꺼번에 맞닥뜨리는 부담을 줄이는 curriculum이다. 짧은 발화가 항상 의미적으로 쉬운 것은 아니며, 모든 epoch를 길이순으로 고정하는 방법도 아니다.
데이터 병렬 학습과 통신. 여러 GPU에 같은 모델을 두고 서로 다른 미니배치 조각을 처리한 다음 기울기를 합쳐 갱신한다. AlexNet의 모델 분할과 다르다. GPU를 늘려도 통신이 늦으면 기다리는 시간이 커지므로, all-reduce와 데이터 공급의 효율도 훈련 속도를 결정한다.
이런 선택은 새로운 기억 이론 하나를 추가한 것과 다르다. 그 대신 원래 가능하던 학습을 더 큰 데이터와 모델에서 반복 가능한 과정으로 만든다. 연구에서 측정해야 할 대상이 정확도뿐 아니라 실험 한 번의 시간과 자원 비용까지 넓어진다.
10. 실시간 전사에서는 미래를 얼마나 기다릴 수 있나
양방향 RNN은 앞뒤 문맥을 이용할 수 있지만, 녹음 전체나 충분한 미래 입력을 기다려야 한다. 실제 사용자가 말하는 즉시 결과를 받아야 하는 상황에서는 지연이 문제가 된다.
DS2의 row convolution은 단방향 순환 출력 위에서 제한된 미래 문맥을 활용하는 선택이다. 미래를 전혀 보지 않는다는 뜻이 아니다. 볼 범위를 제한해서 정확도와 대기 시간 사이를 조정한다. ‘양방향과 같은 문맥을 공짜로 얻는다’고 이해하면 안 된다.
추론에서 낮은 정밀도의 수치 표현을 사용하면 메모리와 대역폭 비용을 줄일 수 있다. 책이 설명하는 FP16 최적화는 추론 쪽 맥락으로 읽어야 한다. 이를 곧바로 전체 훈련이 현대적인 mixed precision이었다고 바꾸어 기억하지 않는다. 여러 요청을 작은 배치로 묶는 batch dispatch도 GPU 활용률을 높이지만, 지나치게 기다려 묶으면 사용자 지연이 커진다.
마지막으로 프레임별 가장 높은 기호만 고르는 greedy decoding이 가장 높은 확률의 전사문을 보장하지는 않는다. 여러 경로가 같은 전사문으로 합쳐질 수 있기 때문이다. Beam search는 유망한 부분 전사 후보들을 남기며 탐색하고, 외부 언어 모델의 점수도 이용해 소리만으로 모호한 선택을 보완한다. 이는 근사 탐색이며 beam을 넓히면 비용이 늘어난다. DS2의 구조·학습·배포 선택은 원 논문에 함께 제시되어 있다.
11. 성능표를 읽기: 어떤 음성에서 누구와 비교했나
음성 인식의 대표 척도인 word error rate(WER)는 정답 전사문과 비교한 단어 대치(S), 삭제(D), 삽입(I)의 수를 정답 단어 수 N으로 나눈 값이다.
WER = (S + D + I) / N
정답이 10단어이고 대치 1개, 삭제 1개, 삽입 1개가 있으면 WER은 30%다. 문장 전체가 틀린 비율이 아니고, 삽입이 많으면 100%를 넘을 수도 있다. 비교 시 대소문자·구두점·숫자 등의 정규화 조건도 맞아야 한다.
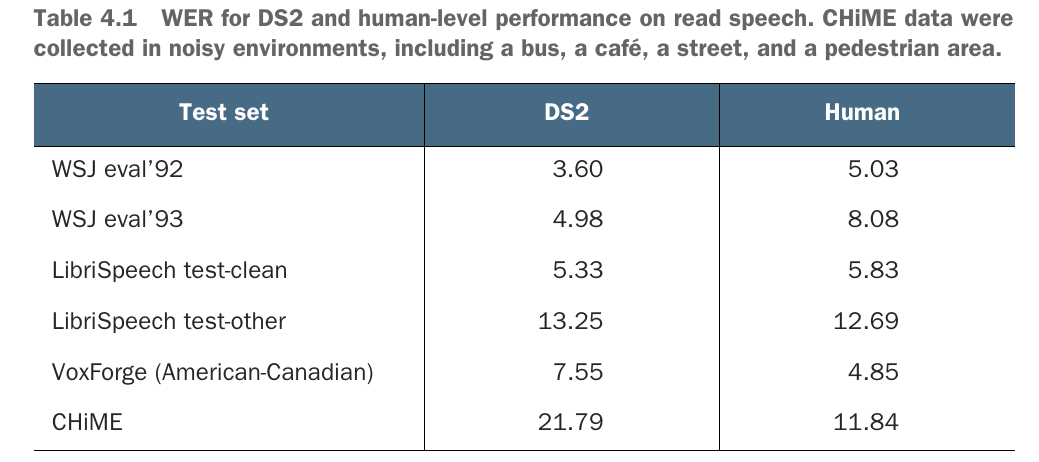
먼저 낮을수록 좋다는 점을 확인한다. WSJ eval’92는 DS2 3.60%, 사람 5.03%로 DS2 쪽 오류가 작다. 그러나 LibriSpeech test-other에서는 13.25% 대 12.69%로 관계가 바뀌고, CHiME에서는 21.79% 대 11.84%로 차이가 커진다. 소음과 발화 조건에 따라 강점이 달라진다는 사실을 한 표에서 볼 수 있다.
따라서 이 표의 결론은 ‘음성 인식에서 인간을 완전히 넘었다’가 아니다. 특정 읽기 음성 테스트와 특정 사람 전사 조건에서 높은 성능을 얻었지만 어려운 음향 조건에서는 차이가 남았다는 것이다. 사람 비교군도 전문 전사자의 다단계 검수와 같은 조건은 아니므로, 누구를 어떤 절차로 측정했는지 함께 봐야 한다.
벤치마크 성능은 구체적인 능력의 증거이며, 모든 상황의 일반적 능력을 대신하는 증명은 아니다.
12. 순환 모델의 한계
순환 모델은 이전 시점의 상태가 계산되어야 다음 시점으로 진행할 수 있다. 이 의존성 때문에 긴 시퀀스의 시간축 연산을 한꺼번에 병렬화하기 어렵다. 고정된 크기의 상태에 필요한 정보를 계속 남겨야 한다는 부담도 있다. LSTM이 정보의 보존과 갱신을 조절하더라도, 문맥이 길어질수록 어떤 정보를 유지할지 학습하는 문제는 남는다.
복습: 빈 종이에 다시 써 볼 것
RNN의 다음 시점에 넘어가는 것은 무엇인가? 이전 예측 단어만이 아니라 hidden state다. 생성할 때 선택한 토큰을 다음 입력으로 쓰는 것과 상태 전달을 구별한다.
BPTT가 어려운 이유는? 시간축으로 펼친 여러 전이의 미분을 곱해야 한다. 기울기 소실·폭발과 긴 계산 그래프의 비용이 생긴다. clipping은 폭발을 제어하지만 기억 문제 전체를 해결하지 않는다.
LSTM의 핵심 두 식은? cₜ = fₜ ⊙ cₜ₋₁ + iₜ ⊙ gₜ, 그리고 hₜ = oₜ ⊙ tanh(cₜ)다. 앞 식은 보존과 쓰기, 뒤 식은 드러내기를 담당한다.
선택적 dropout이 보호한 것은? 시간축의 순환 경로다. 비순환 연결에 정규화를 적용해 과적합을 줄이되 기억의 전달을 매번 무작위로 끊지 않았다.
PPL이 낮다는 말은? 같은 평가 조건에서 실제 정답 토큰에 더 높은 확률을 준다는 뜻이다. 단위가 다른 모델끼리 비교하거나 일반 지능 점수로 쓰지 않는다.
CTC는 정렬 레이블 없이 어떻게 배울까? 정답 전사문으로 축약되는 가능한 프레임 경로들의 확률을 합쳐 학습한다. 전사문 자체는 필요하며, blank와 반복 기호의 처리 규칙이 핵심이다.
DS2가 end-to-end라면 외부 언어 모델은 없는가? 아니다. 학습되는 음향-문자 경로와 실제 전사문을 고르는 decoding 시스템의 범위를 구별해야 한다.
사람보다 좋은 WER을 얻으면 음성을 완전히 이해한 것인가? 특정 전사 조건의 성과다. 잡음, 억양, 데이터 분포, 사람 비교군이 달라지면 결과가 달라질 수 있다.