Attention, 필요한 정보에 닿는 법
들어가며: 필요한 정보를 직접 참조하기
4장에서 RNN은 문장과 음성을 한 단계씩 처리했다. LSTM은 오래 기억할 통로를 만들었고, selective dropout은 그 통로를 훼손하지 않으면서 일반화를 개선했다. 이제 질문을 한 단계 바꿔 보자. 앞에서 나온 정보를 뒤에서 사용하려면, 꼭 모든 중간 시점을 거쳐 전달해야 할까?
5장의 핵심은 필요한 정보가 있는 위치를 직접 참조하도록 계산 구조를 바꾼 것이다. Attention은 번역기의 보조 장치에서 시작해 입력을 선택하고, 메모리에 접근하고, 문장 내부의 관계를 계산하는 방법으로 확장된다. Transformer는 이 접근을 병렬 계산에 적합한 구조로 묶었다.
1. Attention이 바꾼 정보 접근 방식
초기 Seq2Seq, Bahdanau attention, Transformer는 앞에서 나온 정보를 뒤에서 사용하는 경로가 서로 다르다. 이 차이를 먼저 살펴보면 각 구조가 해결한 문제를 연결할 수 있다.
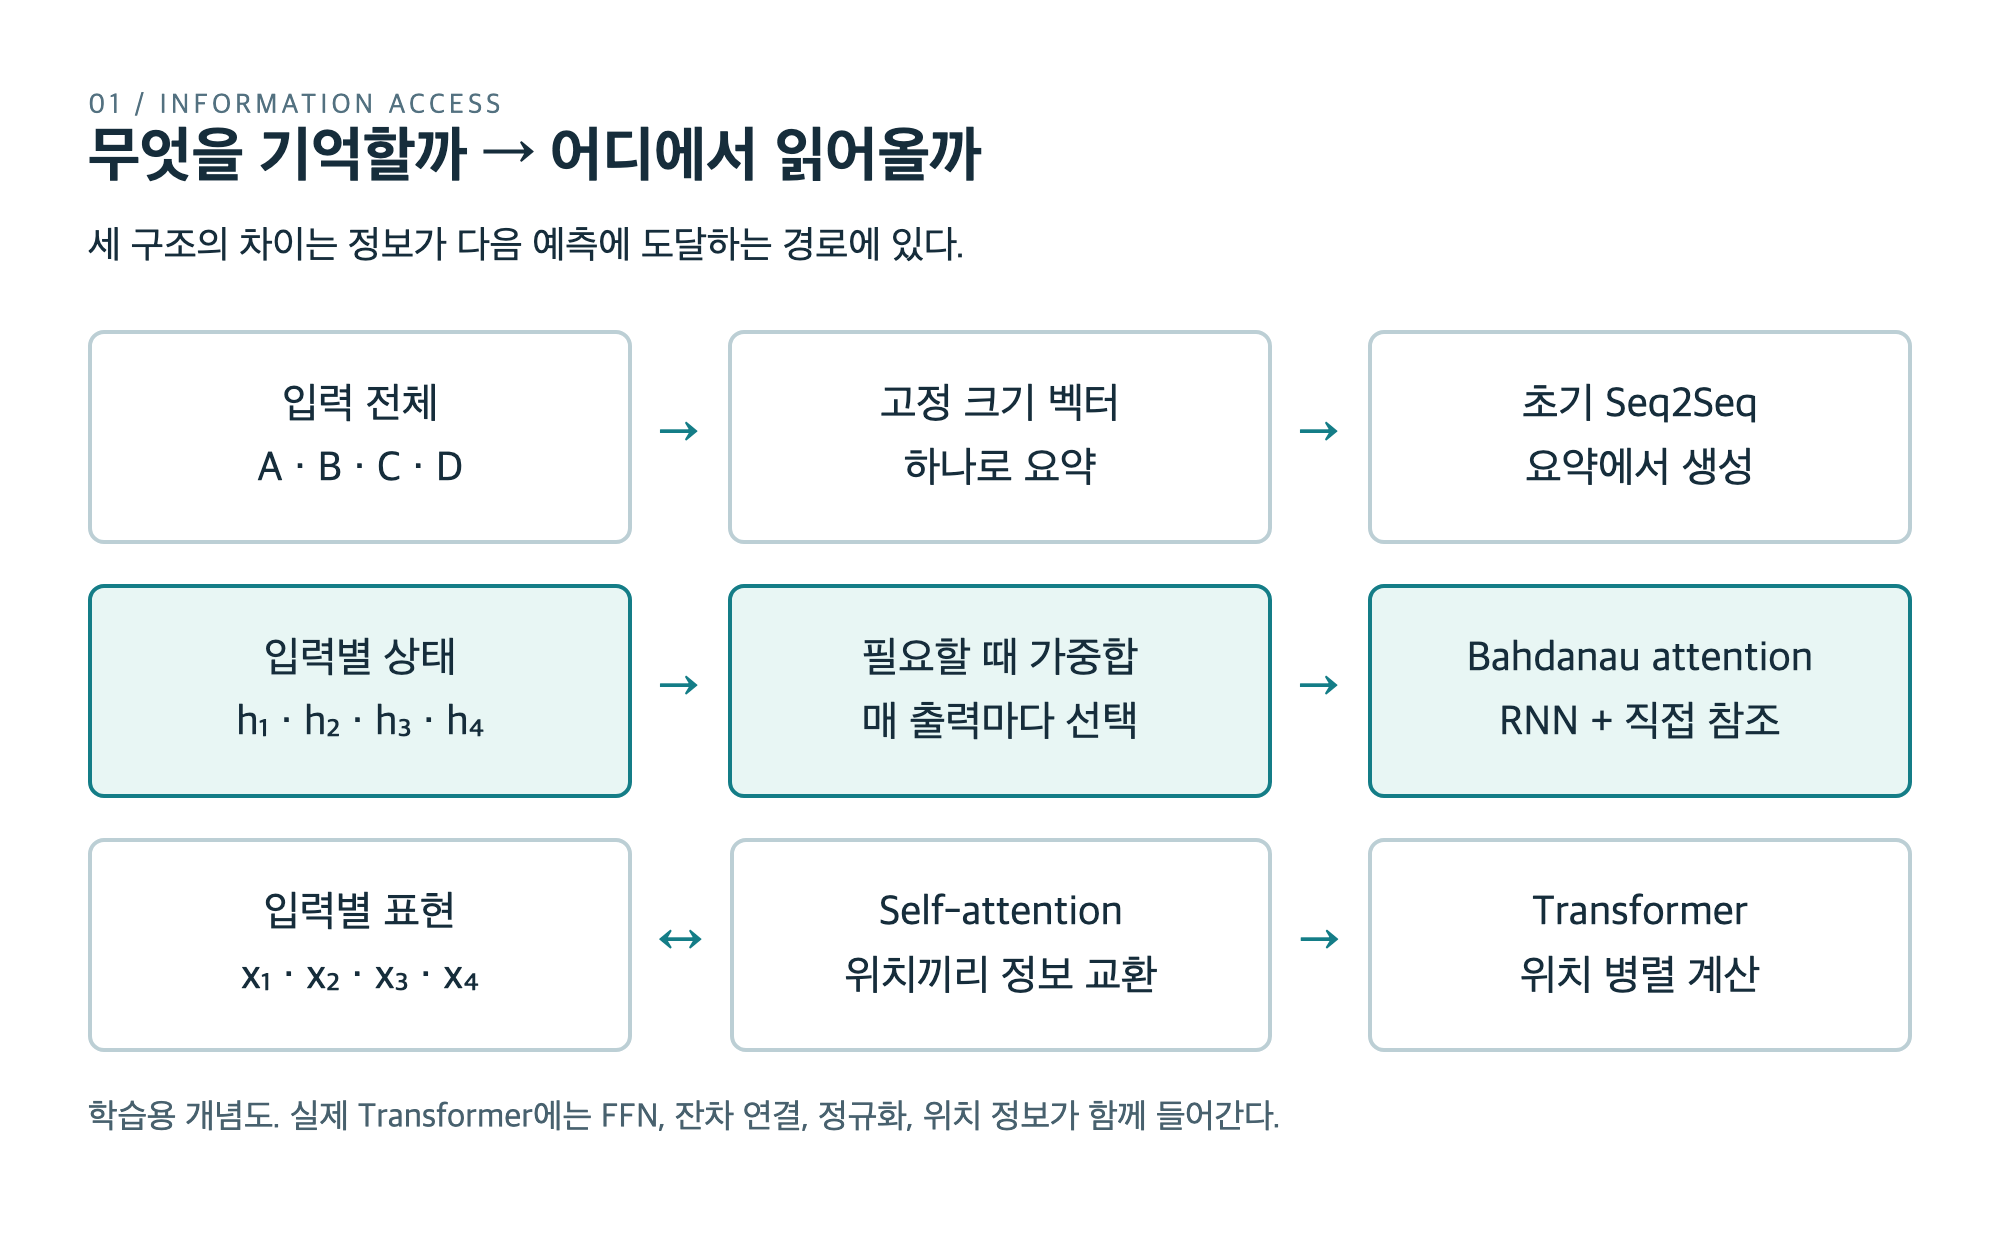
도표 1. 정보 접근 방식의 변화. 관련 논문을 바탕으로 직접 구성한 학습용 도표의 스크린샷.
그림에서 첫 줄은 모든 입력 정보를 작은 통로로 모은다. 둘째 줄은 입력 위치별 표현을 남겨 두고 출력할 때마다 다시 읽는다. 셋째 줄에서는 입력의 각 위치 자체가 다른 위치의 정보를 가져와 표현을 갱신한다. “Attention을 사용한다”는 말은 같아도, 어디에서 무엇을 읽는지는 구조마다 다르다.
2. 이전 모델의 문제: 기억 용량과 전달 경로
하나의 thought vector에 문장을 담는 방식
초기 encoder–decoder를 번역기로 생각해 보자. Encoder가 한국어 문장을 처음부터 끝까지 읽는다. 그 결과를 고정된 크기의 내부 상태로 만들고, decoder가 그 상태를 받아 영어 문장을 생성한다. 입력과 출력의 길이가 달라도 학습할 수 있다는 점이 큰 진전이었다.
문제는 짧은 문장도, 여러 절이 이어진 긴 문장도 같은 크기의 통로를 지나간다는 것이다. 마지막 단어를 읽을 때까지 앞부분의 인물, 관계, 수식어, 시제 정보를 유용한 형태로 보존해야 한다. LSTM의 게이트가 이를 돕지만, 모든 세부 사항이 자동으로 남는 것은 아니다.
여기서 병목을 단순히 “벡터의 숫자가 적어서”라고만 이해하면 부족하다. 무엇을 보존할지 학습해야 하고, 관련 정보가 여러 상태 갱신을 통과해야 한다. 정보 저장과 최적화가 함께 얽힌 문제다. 벡터 차원을 키우는 것은 한 방법이지만, 정보에 접근하는 경로를 바꾸는 것도 가능하다.
Bahdanau attention의 해결책
Bahdanau 등의 RNNsearch는 마지막 상태 하나에만 의존하지 않는다. 양방향 RNN으로 입력 위치마다 표현을 만들고, 출력 단어를 생성할 때마다 그 표현들을 다른 비율로 섞는다. 번역해야 할 부분이 바뀌면 참조하는 위치도 바뀐다.
예를 들어 “빨간 사과”를 형용사가 명사 뒤에 오는 언어로 번역한다면, 입력의 첫 단어부터 같은 순서로 따라갈 필요가 없다. 명사를 만들 때는 사과에 관한 표현을, 색을 만들 때는 빨간에 관한 표현을 더 많이 참조할 수 있다. 이 대응 관계를 사람이 문장마다 표시해 주지 않아도 번역 손실로 학습한다.
수식에서 출력 시점을 t, 입력 위치를 i라고 하면 다음처럼 볼 수 있다.
h는 입력 위치별 표현, s는 decoder의 상태다. 점수 함수 a가 둘의 관련도를 계산한다. Softmax는 점수를 합이 1인 가중치로 바꾸고, c는 그 가중치로 만든 문맥 벡터다. 하나의 고정된 요약 대신, 출력 시점마다 필요한 요약을 새로 만든다.
가중치가 가장 큰 위치만 고르는 것은 아니다. 여러 위치의 정보를 연속적인 비율로 섞기 때문에 미분할 수 있고, 전체 번역기를 역전파로 학습할 수 있다. 다만 이 모델은 여전히 RNN이다. Attention의 등장과 순환 구조의 제거를 같은 사건으로 보면 안 된다. Bahdanau et al., 2014/2015
3. Transformer를 아래에서 위로 읽기
2017년 Transformer는 encoder와 decoder라는 큰 틀을 유지하면서, 순서대로 상태를 전달하던 RNN을 self-attention과 feed-forward network로 대체했다. 여기서 self는 질문과 참고할 정보가 같은 시퀀스에서 나온다는 뜻이다.
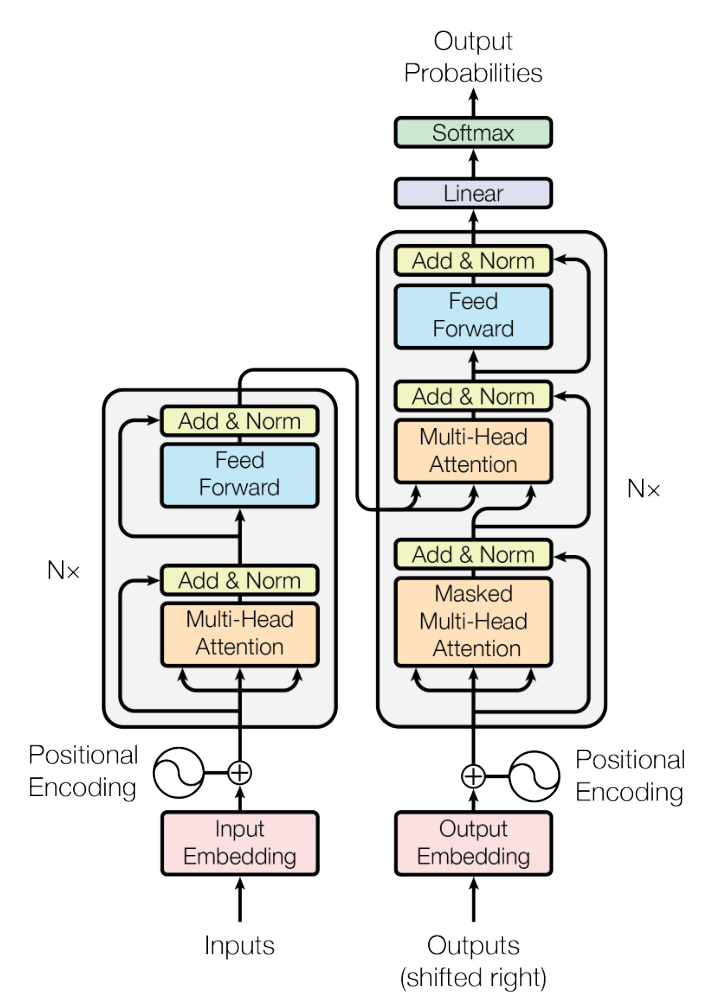
도표 2. Vaswani et al., 「Attention Is All You Need」 Figure 1, PDF 3쪽에서 도표 영역을 캡처했다. 원 논문의 도표는 출처를 명시한 학술·보도 용도 재사용을 허용한다. 원문
첫 단계: 토큰 ID를 벡터로 바꾼다
토큰 ID는 사전의 항목 번호다. 100번이 200번보다 의미가 작거나 비슷하다는 뜻이 아니다. Embedding은 번호를 학습 가능한 벡터에 대응시키는 표다. 원 논문의 base 모델에서 한 토큰의 표현 폭은 512였다.
길이가 n인 입력을 벡터로 바꾸면 n행 512열의 행렬이 생긴다. 각 행은 한 토큰의 표현이다. 처음에는 같은 토큰이 같은 embedding을 받지만, attention을 통과하면 주변 문맥에 따라 다른 표현으로 바뀐다. “배를 먹었다”와 “배를 탔다”의 배가 문맥에 맞게 구분될 수 있는 지점이다.
Encoder: 위치 사이의 정보 교환과 위치별 변환
그림의 왼쪽 블록을 아래에서 위로 읽으면 embedding과 위치 정보를 더한 다음 multi-head self-attention을 거친다. 각 토큰이 다른 토큰을 참고해 자신의 표현을 갱신한다. 이어서 feed-forward network가 각 위치의 벡터를 비선형적으로 변환한다.
둘의 역할을 구별하면 구조가 명확해진다. Attention은 위치 사이에서 정보를 이동시킨다. FFN은 모인 정보를 각 위치에서 가공한다. 원래 base 모델의 FFN은 512차원을 2048차원으로 늘렸다가 ReLU를 거쳐 다시 512차원으로 줄인다. 같은 FFN의 파라미터를 모든 위치에 적용한다.
각 부분에는 residual connection과 layer normalization이 있다. Residual connection은 입력을 출력에 더해 정보와 기울기가 지나갈 경로를 유지한다. 이 대목은 3장의 ResNet과 연결된다. 제목에 attention이 들어 있어도, 모델이 attention 연산 하나만으로 이루어진 것은 아니다.
Decoder: 지금까지 만든 문장과 원문을 함께 본다
그림의 오른쪽 decoder에는 attention이 두 번 나온다. 첫 번째는 이미 입력된 출력 토큰끼리의 masked self-attention이다. 두 번째는 encoder의 출력에서 정보를 가져오는 cross-attention이다. 다음 단어를 만들 때 “지금까지 무엇을 썼는가”와 “원문에 무엇이 있었는가”를 함께 활용한다.
Self-attention에서는 Q, K, V가 같은 시퀀스의 표현에서 나온다. Cross-attention에서는 Q가 decoder에서, K와 V가 encoder에서 나온다. 마지막 선형층은 decoder 표현을 어휘별 점수로 바꾸고, softmax가 다음 토큰의 확률을 만든다.
원 논문은 번역을 위해 encoder와 decoder를 모두 사용한다. GPT 계열의 decoder-only 모델을 이해할 때는 이 그림의 오른쪽을 그대로 복사했다고 생각하기보다, 인과적 self-attention을 중심으로 한 후손이라고 보는 편이 정확하다. 별도 encoder가 없는 일반적인 decoder-only 블록에는 이 그림과 같은 encoder–decoder cross-attention이 없다.
4. Q·K·V를 작은 계산으로 이해하기
Query, Key, Value라는 이름은 추상적이지만 역할은 단순하다. 현재 위치가 필요한 정보를 찾기 위한 벡터가 Q, 각 위치가 비교 대상으로 내놓는 벡터가 K, 실제로 전달할 내용이 V다. 이 설명은 기억을 돕는 비유이며, 벡터의 각 좌표에 사람이 정한 의미 이름이 붙어 있지는 않다.
같은 입력 표현 X에 서로 다른 학습 행렬을 곱해 세 벡터 집합을 만든다.
그리고 다음 식으로 정보를 모은다.
식의 앞부분 QKᵀ는 “누가 누구를 얼마나 참고할까”를 계산한다. 뒤의 V와의 곱은 “그 비율로 무엇을 가져올까”를 계산한다. 관련도를 판단하는 표현과 전달하는 표현을 나누면, 비교와 정보 운반을 각각 학습할 수 있다.
숫자 세 개로 따라가기
한 위치가 세 입력을 참고한다고 가정하자. 크기 조절을 마친 점수가 [0, 1, 2]라면, softmax 가중치는 약 [0.090, 0.245, 0.665]다. 가장 큰 점수가 모든 정보를 독점하지는 않지만 가장 높은 비중을 가진다.
세 value 벡터를 각각 [1, 0], [0, 1], [1, 1]이라고 해 보자. 출력은 다음과 같다.
이 숫자는 학습된 모델에서 가져온 관측값이 아니라 설명용 예제다. 중요한 것은 출력이 새 단어 자체가 아니라 참고한 정보를 섞은 벡터라는 점이다. 다음 토큰 확률은 이 뒤의 여러 변환과 최종 출력층을 거쳐 만들어진다.
왜 제곱근으로 나누나
Q와 K의 차원이 커지면 내적 점수의 크기도 커지기 쉽다. Softmax 입력의 차이가 지나치게 커지면 한 위치에 확률이 거의 몰리고, 학습에 필요한 기울기가 작아질 수 있다. 키 차원의 제곱근으로 나누는 것은 점수의 규모를 조절하는 방법이다.
이것은 Q와 K를 단위 벡터로 만들어 cosine similarity를 구하는 연산과 다르다. 또한 모델이 관계를 “정확히 이해하도록 보증”하는 장치도 아니다. 학습이 잘 진행되도록 수치적인 조건을 다듬는 선택이다.
Multi-head는 무엇을 추가하나
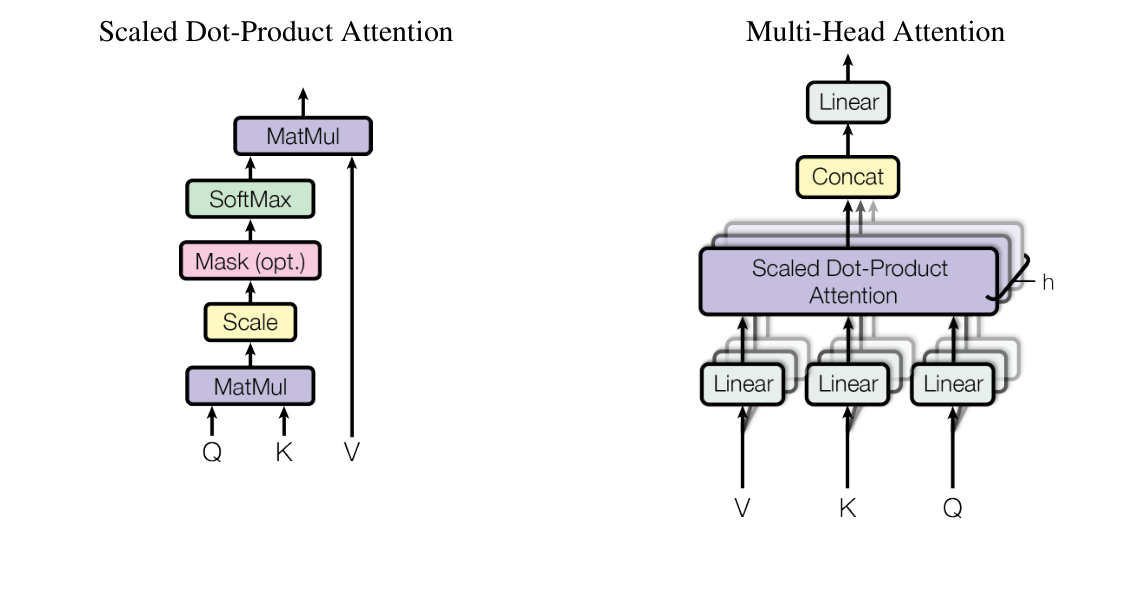
도표 3. 「Attention Is All You Need」 Figure 2, PDF 4쪽의 도표 영역 캡처. 왼쪽은 점수 계산과 가중합, 오른쪽은 여러 head를 병렬로 계산해 결합하는 흐름이다. 원문
하나의 attention만 사용하면 여러 관계가 하나의 가중합 안에 섞인다. Multi-head attention은 서로 다른 투영 행렬을 사용해 여러 표현 공간에서 정보를 모은다. 각 head의 결과를 연결한 뒤 다시 선형 변환한다.
직관적으로는 어떤 head가 가까운 단어의 관계에, 다른 head가 멀리 떨어진 관련 표현에 민감해질 수 있다. 하지만 “1번은 문법, 2번은 의미”처럼 역할이 미리 정해져 있지는 않다. 실제 역할은 학습 결과를 조사해야 알 수 있고, 서로 중복되거나 해석이 불명확할 수도 있다.
원래 base 모델은 폭 512를 8개 head에 나눠 head당 Q와 K의 차원을 64로 사용했다. 매 head가 512차원 전체를 독립적으로 계산하는 방식과 구별해야 한다. 이 선택은 표현의 다양성을 얻으면서 계산량을 관리한다.
5. 순서와 미래 정보는 어떻게 다루나
위치 정보가 필요한 이유
Self-attention의 내용 비교만으로는 토큰이 몇 번째에 있었는지 알 수 없다. “고양이가 개를 쫓았다”와 “개가 고양이를 쫓았다”를 구분하려면 내용뿐 아니라 배치 순서가 중요하다. 원 Transformer는 embedding에 위치 encoding을 더했다.
정확히 말하면, 위치 정보와 인과 마스크가 없는 self-attention은 입력 행을 재배열하면 출력 행도 그에 맞게 재배열되는 성질을 가진다. 이를 permutation equivariance라고 한다. 어떤 순서로 넣어도 출력 행렬이 완전히 같다는 permutation invariance와는 다르다.
원 논문은 여러 주기의 sin과 cos로 위치를 표현했다. 좌표별로 변화 속도를 다르게 해 위치를 구별할 수 있는 패턴을 제공하는 것이다. 특정 위치 표현 방식이 무한히 긴 문장에 대한 일반화를 보장하지는 않는다. 장기 문맥 성능은 학습 길이, 모델, 데이터와 함께 평가해야 한다.
학습을 병렬화해도 정답을 훔쳐보면 안 된다
언어 모델은 앞의 토큰을 조건으로 다음 토큰의 확률을 예측한다. 전체 문장의 확률은 조건부 확률들의 곱으로 나타낼 수 있다.
훈련할 때는 정답 문장을 이미 알고 있으므로 여러 위치의 예측을 한꺼번에 계산할 수 있다. 하지만 예측할 정답이 입력 쪽에서 보이면 문제가 너무 쉬워진다. 입력과 정답을 한 칸 어긋나게 놓고, 각 위치에서 미래 입력을 가리는 causal mask를 사용한다.
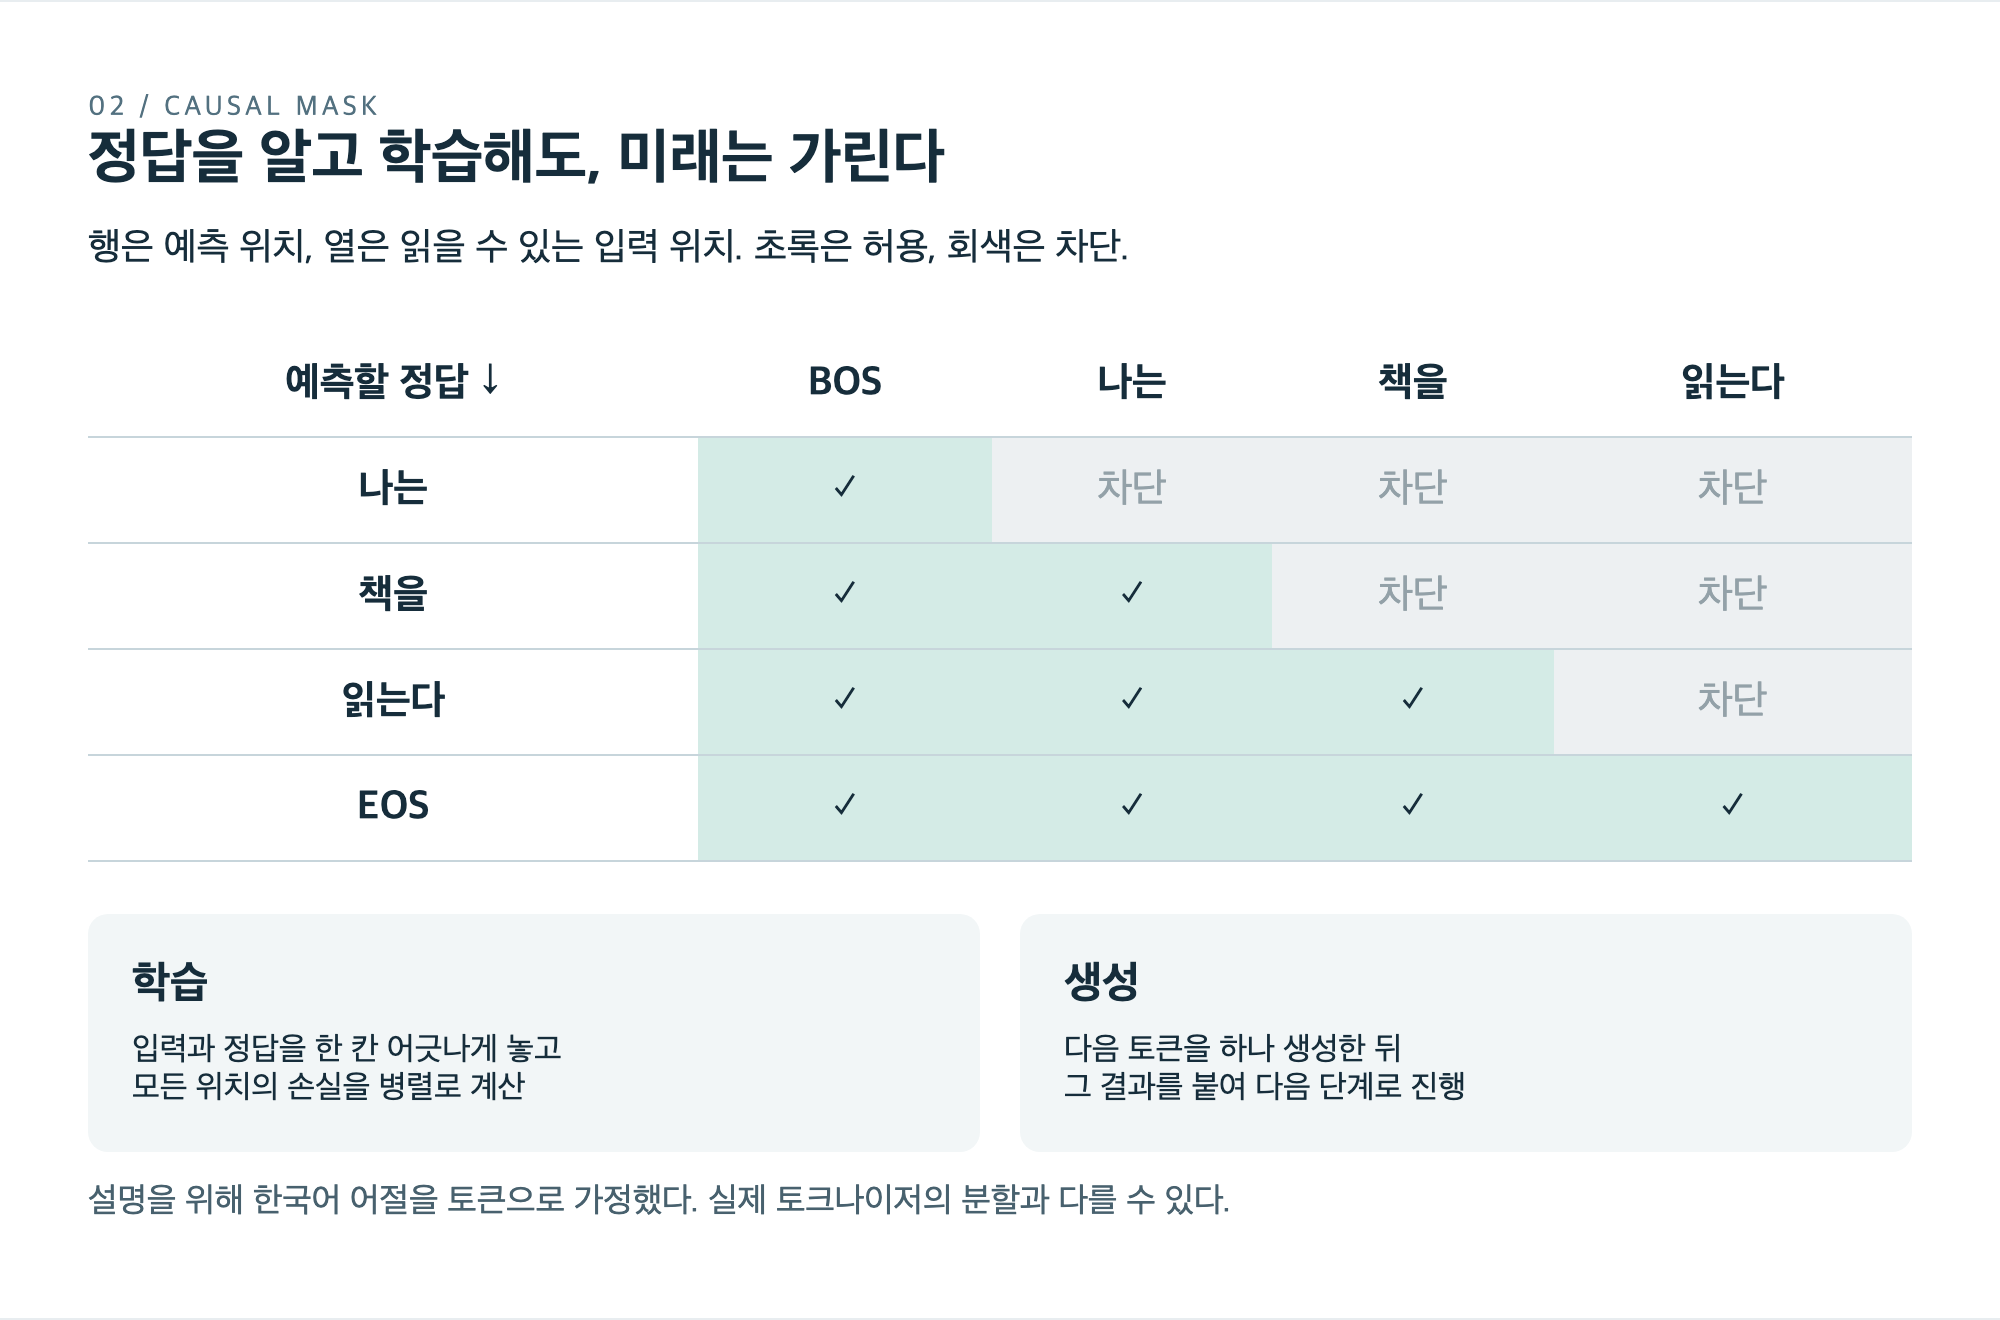
도표 4. Causal mask의 예시를 직접 구성하고 캡처했다. BOS는 시작, EOS는 종료를 나타낸다. 실제 한국어 토큰 분할을 재현한 그림은 아니다.
그림의 “책을” 예측 행은 BOS와 “나는”까지 읽을 수 있다. “책을”이라는 정답은 그보다 오른쪽 입력 위치에 있으므로 보이지 않는다. 점수 행렬에서 차단할 칸을 음의 무한대로 처리하면 softmax 이후 그 가중치는 0이 된다.
표의 대각선이 허용되어 있다는 점도 중요하다. 각 위치의 입력은 자신이 예측할 정답보다 한 칸 앞에 놓여 있다. 따라서 “자기 위치까지 본다”와 “정답 토큰을 본다”는 같은 말이 아니다. Shift와 mask를 함께 봐야 한다.
생성할 때는 아직 다음 토큰이 없으므로 한 토큰을 만든 후 그것을 조건에 추가한다. 학습의 위치별 병렬화와 생성의 순차성은 함께 존재한다. Padding mask는 길이가 다른 문장을 묶을 때 추가한 빈칸을 가리는 것으로, 미래를 가리는 causal mask와 목적이 다르다.
6. 무엇이 빨라졌고, 무엇은 비싼가
RNN은 한 시점의 상태를 계산하려면 이전 시점의 상태가 필요하다. 문장이 길어질수록 순서대로 수행해야 할 단계가 늘어난다. Transformer의 한 층에서는 여러 위치의 Q·K·V와 관련도를 행렬 연산으로 함께 계산할 수 있다. GPU가 잘 처리하는 연산 형태와 잘 맞는다.
멀리 떨어진 두 위치가 정보를 주고받는 경로도 달라진다. RNN에서는 여러 시간 단계를 거치지만, 완전한 self-attention에서는 한 번의 attention으로 연결될 수 있다. 이것은 장거리 관계를 학습하기에 유리한 조건이지, 실제로 어떤 거리의 관계든 항상 잘 학습한다는 보증은 아니다.
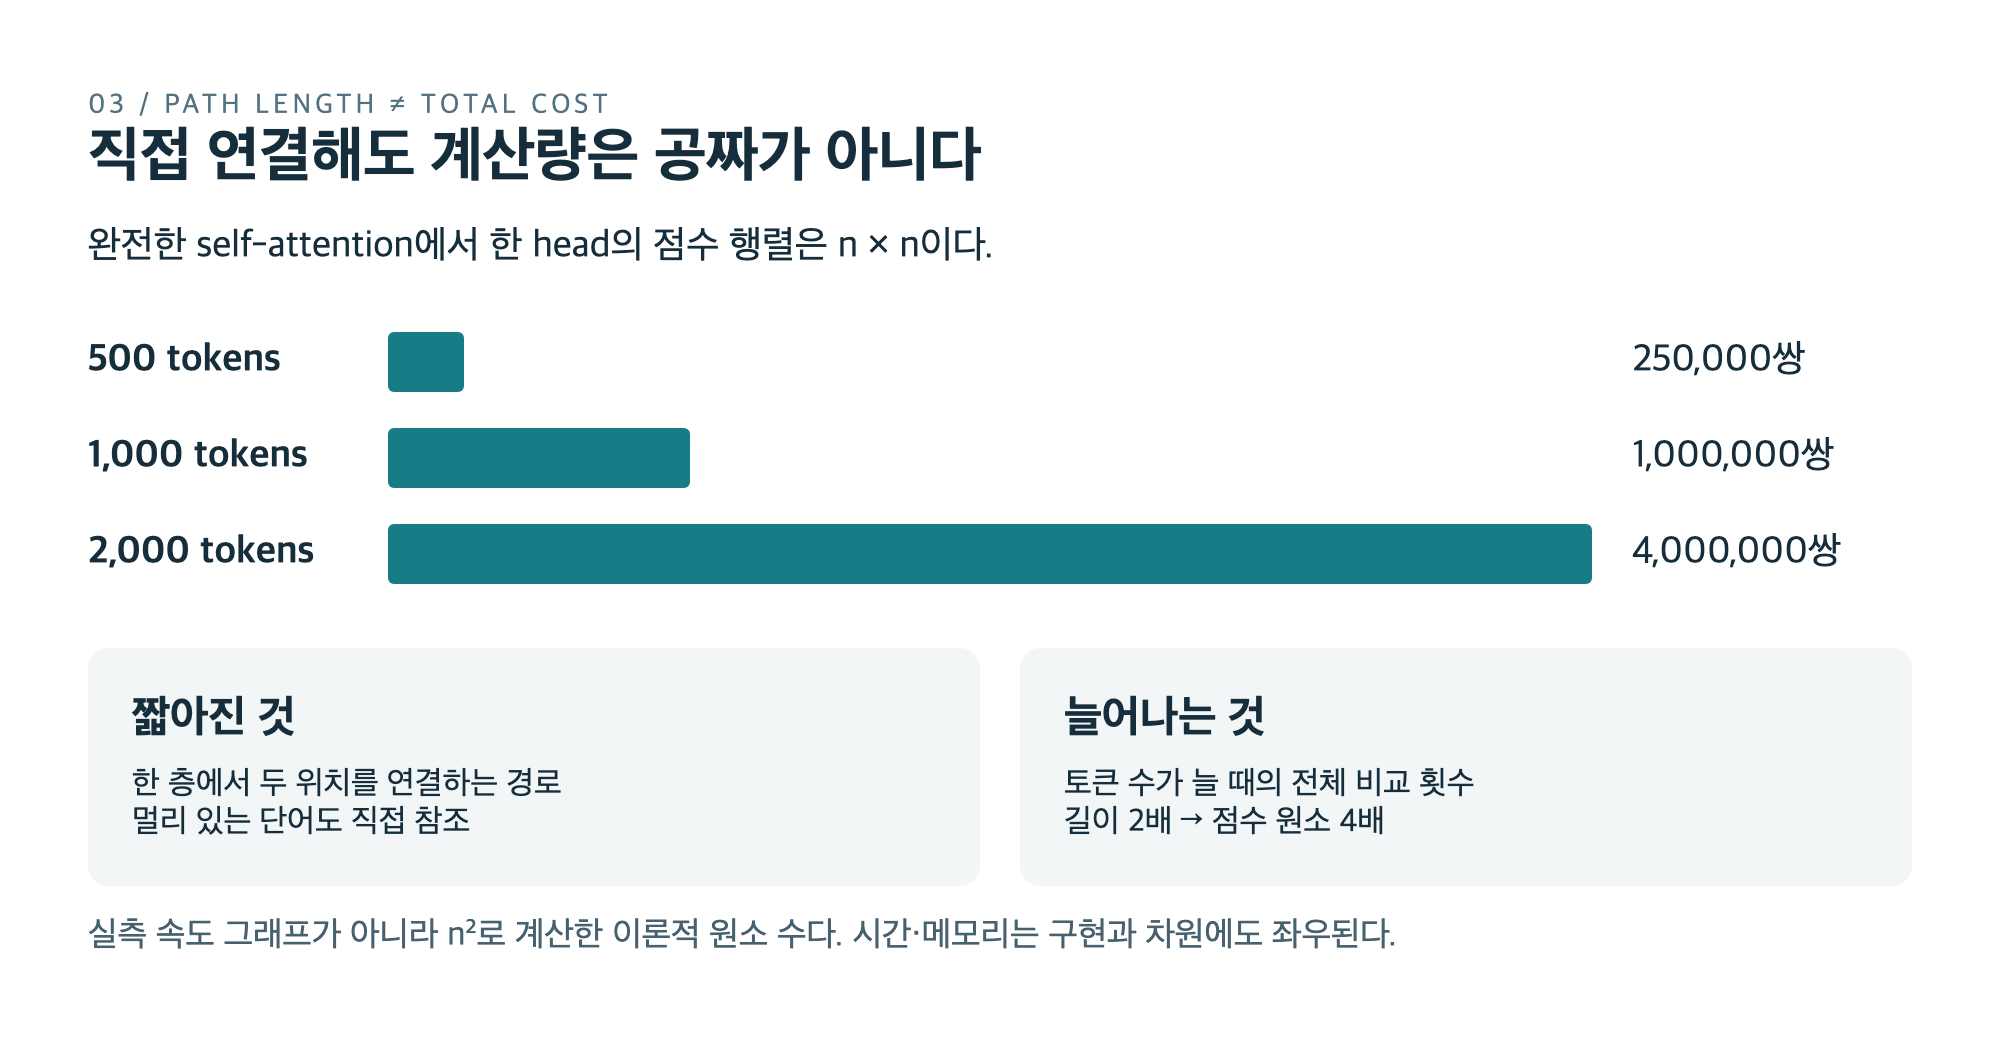
도표 5. 한 head의 점수 행렬 원소 수 n²를 계산해 만든 도표. 실측 실행 시간이나 벤치마크 점수가 아니다.
반대편 비용도 있다. 입력 길이가 n이면 완전한 attention의 점수 행렬은 n×n이다. 500개 토큰의 25만 쌍이 1,000개에서는 100만 쌍이 된다. 두 위치 사이 경로는 짧아졌지만 모든 위치를 비교하는 총량은 커진다.
따라서 “거리와 무관하게 직접 참조한다”를 “문장이 길어져도 계산 비용이 같다”로 읽으면 안 된다. Head 수, 층 수, 벡터 차원, 구현 방식까지 전체 비용에 영향을 준다. 이후의 효율적인 attention 연구들은 이 계산과 메모리 부담을 다룬다.
결과 표에서 확인할 것
- Transformer base — WMT14 영어→독일어 BLEU: 27.3; 영어→프랑스어 BLEU: 38.1; 학습 환경·시간: P100 GPU 8개, 약 12시간
- Transformer big — WMT14 영어→독일어 BLEU: 28.4; 영어→프랑스어 BLEU: 41.8; 학습 환경·시간: P100 GPU 8개, 약 3.5일
수치는 「Attention Is All You Need」의 결과 표와 학습 설명을 따른다. 책 102쪽에는 영어→프랑스어 성능이 41.0으로 서술되어 있지만, 원 논문 표의 big 모델 값은 41.8이다. 당시 비교에서 번역 품질과 학습 효율이 함께 개선되었다는 것이 중요한 결과다. 원 논문 §5–6
BLEU는 정답 번역과의 n-gram 겹침 등을 이용하는 지표다. 특정 데이터와 평가 방식 안에서 유용하지만 인간의 모든 번역 판단을 대변하지 않는다. 또한 Penn Treebank의 perplexity와 WikiText-103의 perplexity는 데이터셋과 조건이 다르므로 숫자만 나눠 “몇 배 좋아졌다”고 말할 수 없다.
7. 왜 구현 해설도 목록에 들어갈까
책의 5.2절은 Alexander Rush의 The Annotated Transformer를 다룬다. 이것은 별도의 새 attention 구조를 발표한 논문이 아니라, 논문 내용과 PyTorch 구현을 함께 따라가게 만든 해설이다.
수식 하나를 이해하는 것과 동작하는 모델을 만드는 것 사이에는 상당한 간격이 있다. 배치와 head의 차원을 어떻게 배열할지, mask를 어느 축으로 확장할지, decoder 입력을 어떻게 이동할지, 손실에서 padding을 어떻게 제외할지 결정해야 한다.
예를 들어 softmax를 잘못된 축에 적용하면 코드가 실행되어도 “각 query가 어떤 key를 얼마나 볼지”라는 의미가 무너진다. 학습 시 미래를 보도록 잘못 구현하면 손실은 좋아 보이지만 실제 생성 성능은 기대에 못 미친다. 코드와 개념을 함께 설명하는 자료가 필요한 이유다.
이 절은 지식의 확산도 기술 발전의 일부임을 보여준다. 4장의 Karpathy와 Olah가 RNN과 LSTM을 이해하게 도왔듯, Annotated Transformer는 새로운 구조를 직접 구현하고 실험할 수 있게 만들었다. The Annotated Transformer
8. Attention은 문맥을 모으는 것 이상이다
Pointer Networks: 답이 입력 안에 있다면
번역 모델의 출력 후보는 보통 정해진 어휘다. 그런데 도시 좌표들을 받고 방문 순서를 출력하는 문제라면, 답은 “사전에 등록된 단어”가 아니라 “이번 입력의 몇 번째 도시인가”가 된다. 도시 수가 달라지면 출력 후보 수도 달라진다.
Pointer Network는 attention의 위치별 확률을 문맥 벡터를 만드는 중간 과정으로만 사용하지 않고, 출력 분포로 사용한다. 입력이 10개이면 10개 위치 위의 분포를 만들고, 50개이면 50개 위치 위의 분포를 만든다. 입력 원소를 선택하는 문제가 구조에 자연스럽게 반영된다.
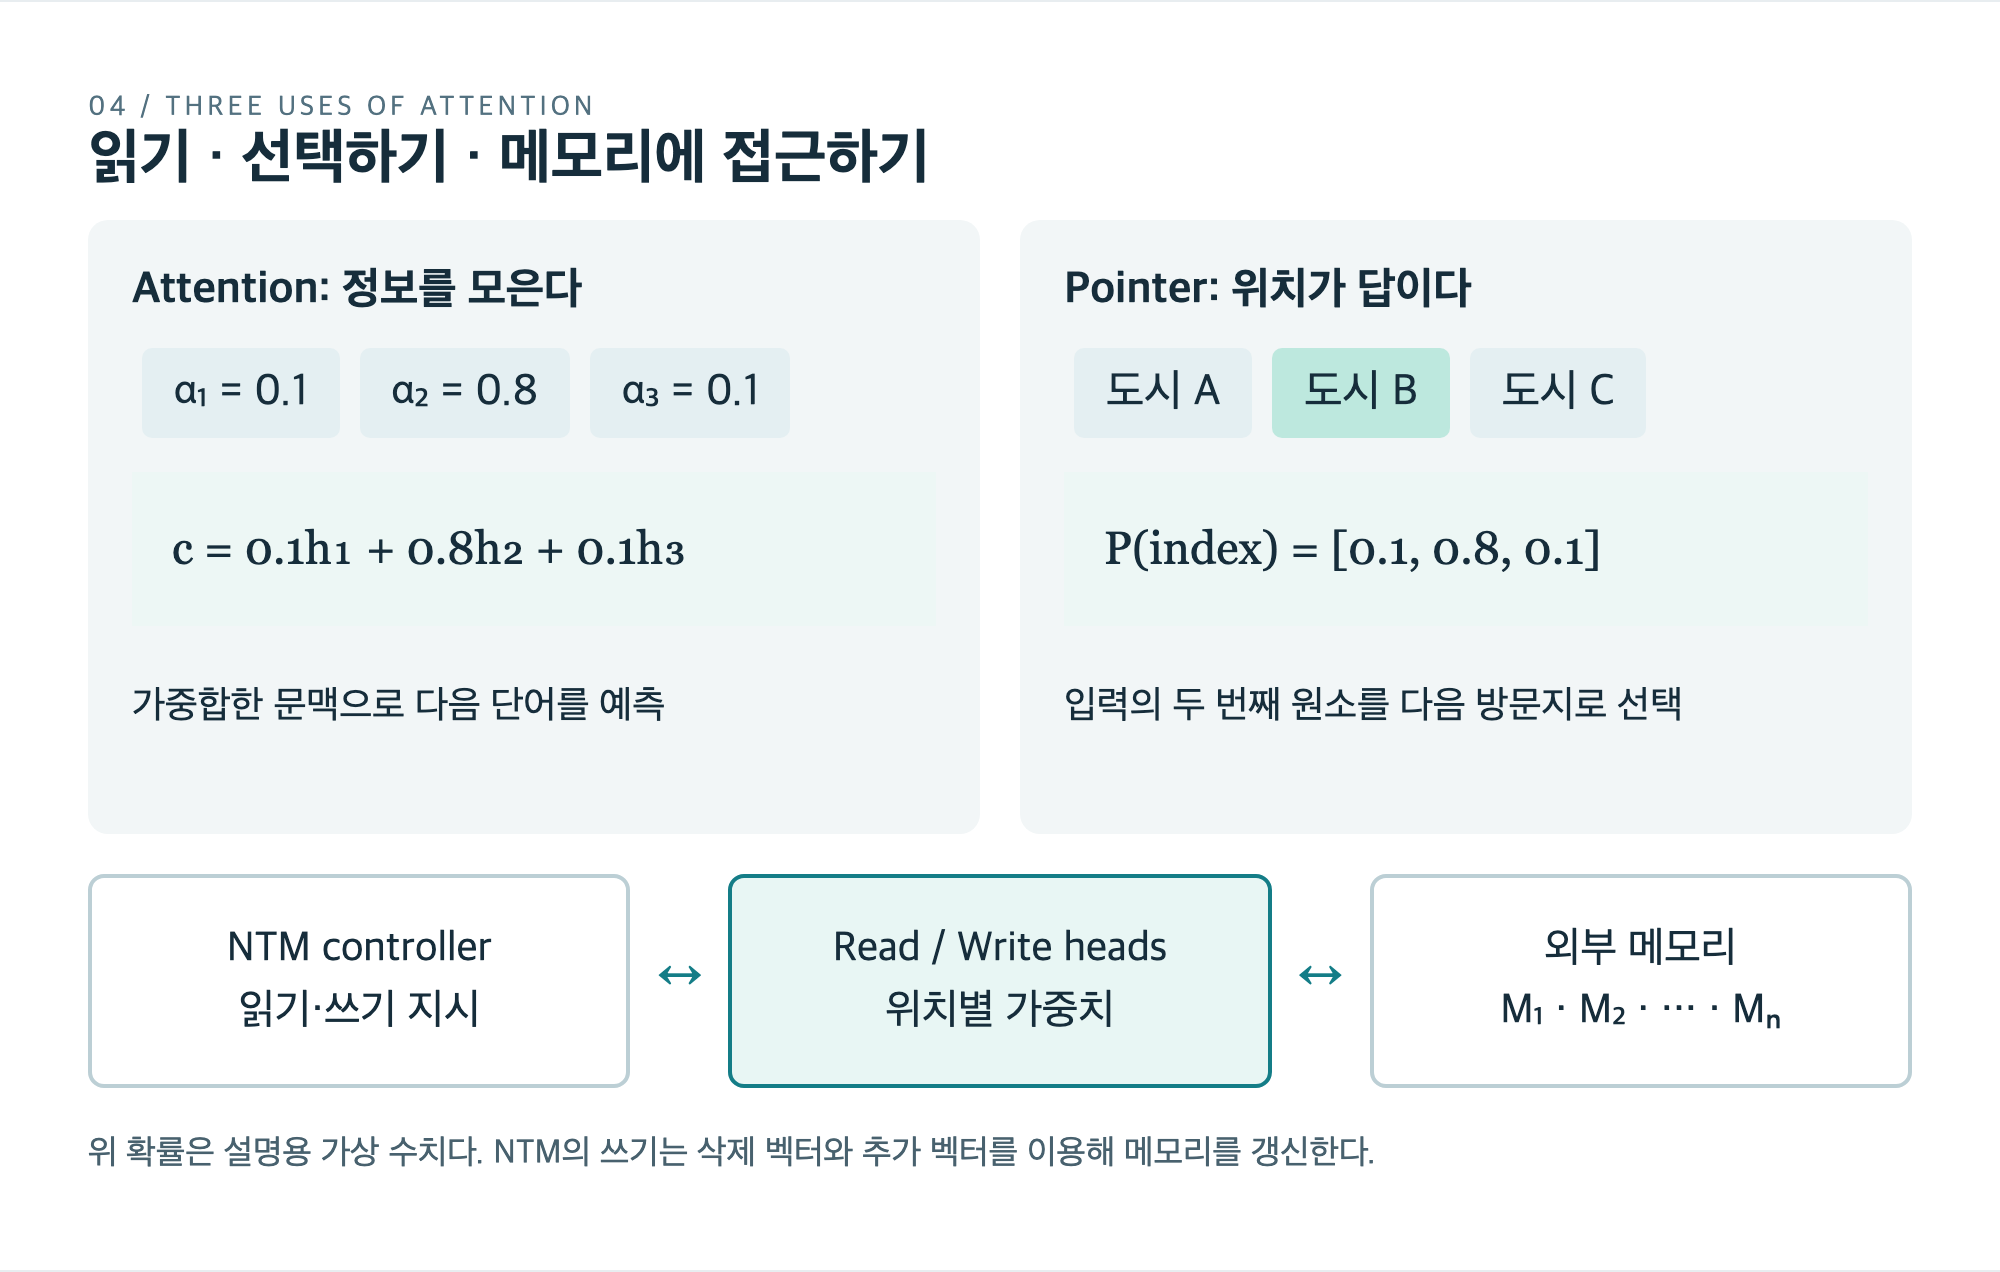
도표 6. 관련 논문을 바탕으로 구성한 개념도 스크린샷. 가중치는 실제 실험에서 관측한 값이 아닌 설명용 수치다.
책의 convex hull 실험을 보면 50개 점에서 정확한 결과를 얻는 비율은 단순 LSTM 1.9%, attention을 추가한 LSTM 38.9%, Pointer Network 72.6%다. Attention을 보조하는 것과 출력 자체를 입력 위치에 맞게 구성하는 것 사이에 큰 차이가 있었다.
다만 지표를 읽을 때 주의해야 한다. 5–50개 점으로 학습하고 500개 점에서 평가한 Pointer Network는 면적 관련 지표가 99.2%였지만, 정확한 출력 전체를 맞힌 비율은 1.3%였다. 도형의 전체 윤곽이 비슷한 것과 정답의 모든 점·순서를 맞힌 것은 다른 성과다.
TSP에서도 좋은 근사 경로를 배웠다는 것이 모든 크기의 문제를 정확하게 해결했다는 뜻은 아니다. 출력 구조를 잘 설계하면 학습이 쉬워질 수 있지만, 조합 문제의 어려움이 사라지는 것은 아니다. Pointer Networks
Neural Turing Machines: 계산과 저장을 나누자
NTM은 신경망 controller에 외부 메모리를 붙인다. Controller는 입력을 처리하면서 어디를 읽고 어디를 수정할지 결정한다. 읽기·쓰기 head가 메모리 위치에 가중치를 주기 때문에 전체 시스템을 미분 가능한 연산으로 구성할 수 있다.
읽기는 메모리 행들을 가중합하는 것으로 생각할 수 있다. 쓰기는 위치별 가중치에 따라 기존 내용의 일부를 지우고 새 내용을 더하는 방식이다. 이 점에서 읽기만 하는 attention 예시보다 한 단계 더 나아간다.
주소를 찾는 방식도 두 종류다. 내용 기반 주소 지정은 현재 찾는 내용과 비슷한 메모리를 고른다. 위치 기반 주소 지정은 특정 위치를 유지하거나 옆 칸으로 이동하는 데 유용하다. 데이터를 복사하는 작업이라면 “지금 읽던 칸의 다음 칸으로 가기” 같은 동작이 필요하다.
이 계열의 연구는 예제만 보고 복사, 정렬, 연관 회상 같은 간단한 알고리즘을 학습할 가능성을 보여주었다. 그렇다고 일반 컴퓨터를 대체하는 신뢰성이나 무제한 장기 기억이 입증된 것은 아니다. Neural Turing Machines
Transformer와의 연결은 개념적으로 이해하면 좋다. Self-attention도 현재 시퀀스의 표현을 읽을 수 있는 메모리처럼 사용한다. 그러나 원 Transformer에는 NTM과 동일한 별도 read–write 메모리 장치가 없다. 문맥 창, 파라미터에 저장된 지식, 외부 검색, NTM의 메모리를 모두 “기억”이라고 부를 수는 있어도 작동 방식은 다르다.
9. 순서는 없애야 할 때와 보존해야 할 때가 있다
Order Matters: 집합을 시퀀스로 바꾸면 생기는 문제
도시 좌표의 집합에는 본래 첫 번째 도시가 없을 수 있다. 같은 점들을 [A, B, C]로 주거나 [C, A, B]로 주어도 같은 기하학적 문제다. 그런데 RNN에 넣으면 상태 갱신의 순서가 달라져 다른 입력처럼 취급된다.
Order Matters는 입력과 출력의 배열 방식이 학습의 난도에 영향을 준다는 점을 다룬다. 입력의 순서가 본질적이지 않다면, 그 순서에 불필요하게 의존하지 않는 표현이 유리하다. 반대로 문장이나 구문 트리의 구조를 학습할 때는 의미 있는 순서를 잘 보존하는 것이 중요하다.
Read–Process–Write는 이 문제에 대응하는 틀이다. Read는 각 원소를 표현으로 바꿔 메모리에 놓는다. Process는 attention으로 메모리를 반복해서 읽으며 상태를 갱신한다. Write는 얻은 상태와 메모리를 이용해 출력을 생성한다. 이때 attention이 모든 원소에 같은 가중치를 준다는 뜻은 아니다. 내용에 따라 다른 가중치를 주되, 임의의 나열 순서에 의존하지 않도록 설계한다.
출력에도 순서 문제가 있다. 같은 순환 경로는 어느 도시에서 시작해 적느냐에 따라 여러 정답 문자열이 될 수 있다. 정답 배열을 적절히 통일하거나, 학습 중 더 적합한 출력 순서를 찾는 목적함수를 사용하면 불필요한 어려움을 줄일 수 있다.
실무적으로는 데이터 전처리도 모델링의 일부라는 교훈을 얻는다. 구조화된 대상을 문자열로 만들 때 “어떤 순서로 쓰느냐”를 단순 포맷 문제로 넘기지 말아야 한다. 같은 사실을 담아도 모델이 포착해야 할 의존성이 달라질 수 있다. Order Matters
입력 반전: 아주 작은 변화가 드러낸 약점
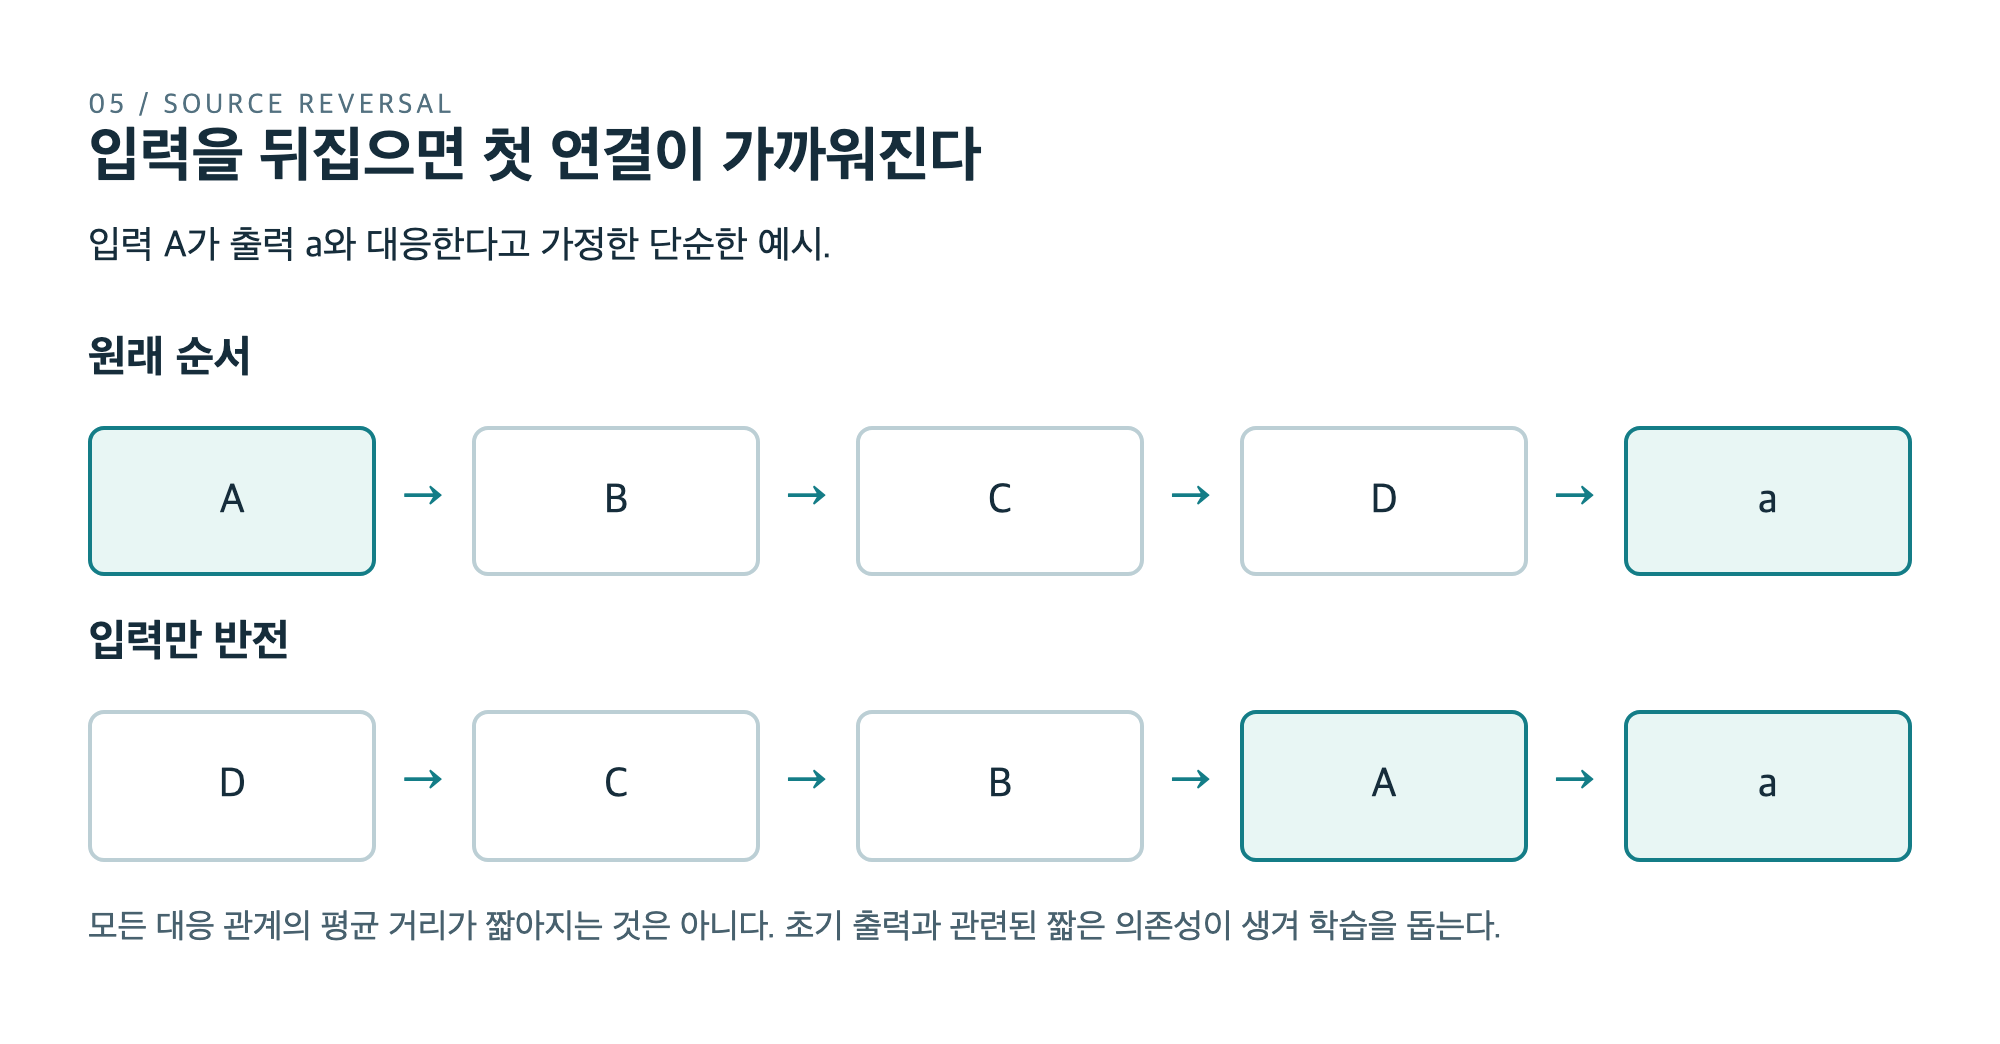
도표 7. Sutskever 등의 Seq2Seq 입력 반전 아이디어를 설명하기 위해 직접 구성한 도표 스크린샷.
초기 Seq2Seq에서 decoder는 encoder가 입력을 모두 읽은 다음 출력을 시작한다. 원문의 첫 단어와 번역문의 첫 단어가 대응한다면, 원문의 첫 단어 정보는 encoder의 마지막까지 전달되어야 첫 출력에 사용될 수 있다.
입력만 뒤집으면 원래 첫 단어가 encoder의 마지막에 온다. 그래서 첫 출력과 관련된 정보가 decoder 시작에 가까워진다. 이 단순한 변화는 원 논문에서 perplexity를 5.8에서 4.7로 낮췄고, 번역 성능도 개선했다.
모든 단어 쌍의 평균 거리가 짧아진 것은 아니다. 일부 초기 대응에서 짧은 의존성이 생겨 학습을 시작하기 쉬워진다는 설명이 핵심이다. 따라서 “모델이 문장을 거꾸로 이해하는 능력을 얻었다”는 이야기와도 다르다.
이 효과는 구조와 언어 쌍에 의존한다. Attention으로 입력 위치에 직접 접근할 수 있게 되면서, 원문 반전은 Transformer의 필수 전처리가 아니게 된다. 문제에 맞춘 임시 해법이 나중의 구조적 해결책을 이해하는 단서가 된 셈이다. Sequence to Sequence Learning with Neural Networks
10. Universal Transformer와 책의 해석을 구분하기
원 Transformer는 층을 쌓아 표현을 갱신한다. Universal Transformer는 같은 변환 블록을 깊이 방향으로 반복 적용한다. 반복마다 전체 위치를 병렬로 처리하므로 RNN처럼 토큰을 하나씩 넘기는 시간축 순환과는 다르다.
어떤 토큰에는 더 많은 계산 단계가 필요할 수 있다는 생각도 포함된다. 적응적 정지 방식은 위치에 따라 반복 계산 횟수를 달리할 수 있게 한다. 이 접근의 관심사는 특정 과제에서의 반복적 계산과 길이 일반화다.
책은 이 연구를 단순한 Transformer의 확장성에 집중하지 못한 우회로라는 시각으로 평가한다. 그러나 “성능 이점은 없고 개념적 장점뿐이었다”는 식으로 외우면 원 논문과 어긋난다. Universal Transformer 논문은 알고리즘 과제와 언어 이해 과제의 개선, 영어→독일어 번역에서 0.9 BLEU 개선을 보고했다.
따라서 두 질문을 나눠야 한다. “논문의 실험 조건에서 개선이 있었는가?”에는 그렇다고 답할 수 있다. “이 구조가 이후 대규모 언어 모델의 지배적인 표준이 되었는가?”는 별개의 역사적 질문이다. 특정 구조가 널리 채택되지 않았다는 사실만으로 실험 성과를 지울 수는 없다. Universal Transformers
또한 특정 가정 아래의 Turing completeness는 임의의 계산을 표현할 수 있다는 이론적 성질이다. 유한한 시간과 메모리로 그 계산을 잘 학습하고 안정적으로 실행한다는 보증이 아니다. 표현 가능성, 학습 가능성, 실행 효율을 나누어 생각하는 연습이 필요하다.
11. 이 장이 말하는 규모 확장의 의미
Transformer의 성과는 새 연산 하나를 발견했다는 것만으로 설명하기 어렵다. Attention, 위치 정보, FFN, 잔차 연결, 정규화, 학습 방법이 맞물렸고, 큰 행렬 연산으로 처리하기에 적합했다. 같은 종류의 블록을 반복하면서 폭과 깊이를 조정할 수 있었다.
이것이 6장의 규모 확장 이야기로 이어진다. 데이터와 연산을 더 투입할 수 있는 것뿐 아니라, 그 투입이 실제 학습으로 이어지는 구조가 중요하다. 3장의 ResNet이 깊은 네트워크의 최적화를 다뤘다면, 5장은 시퀀스 내부의 정보 접근과 병렬화라는 축을 더한다.
책 후반의 “stochastic parrots” 논의는 저자의 비평적 입장으로 읽는 편이 좋다. 다음 토큰 예측이라는 목적함수만 말해서 모델의 능력을 충분히 설명할 수 없다는 지적과, 유창한 출력이 곧 인간과 같은 이해를 입증한다는 주장은 서로 다르다.
원 논문이 실험으로 보여준 것은 attention 중심의 구조가 번역과 구문 분석에서 강한 성능을 낼 수 있다는 것이다. AGI의 충분조건을 증명한 것이 아니다. “Attention is all you need”를 읽을 때 all의 범위를 해당 논문의 문제 설정 안에 두어야 한다.
12. 책과 원 논문을 함께 읽을 때의 확인표
- Transformer가 attention을 처음 만들었다 — 더 정확한 정리: Attention은 앞선 번역·메모리 연구에도 있었다. Transformer는 순환 없이 이를 중심 구조로 사용했다.
- 모든 토큰을 동시에 생성한다 — 더 정확한 정리: 훈련의 위치별 계산은 병렬화할 수 있지만, 자기회귀 생성은 앞에서 만든 토큰에 의존한다.
- 모든 위치와 직접 연결되므로 긴 문장도 같은 비용이다 — 더 정확한 정리: 경로 길이와 총 계산량은 다르다. 완전한 점수 행렬은 n²로 커진다.
- Head마다 문법·의미 역할이 정해져 있다 — 더 정확한 정리: 투영과 관계는 학습된다. 역할 해석은 추가 분석이 필요하다.
- RPW의 attention은 각 원소에 같은 가중치를 준다 — 더 정확한 정리: 내용별 가중치는 달라도 된다. 임의의 입력 나열 순서에 대한 불필요한 의존성을 피하는 것이 핵심이다.
- Universal Transformer에는 실험적 이득이 없었다 — 더 정확한 정리: 원 논문은 여러 과제에서 개선을 보고했다. 책의 역사적 평가는 별개다.
- Pointer Network의 면적 점수가 높으면 정답이다 — 더 정확한 정리: 전체 출력 일치와 기하학적 근사 품질은 다른 지표다.
- 입력 반전은 모든 의존성을 짧게 만든다 — 더 정확한 정리: 초기 대응에 짧은 의존성이 생긴다. 평균 거리 감소와 동일하지 않다.
참고 자료와 도표 출처
이 글의 기준 자료는 Richard Heimann, Sutskever’s List, Chapter 5, pp. 95–128이다. 책의 해설과 원 논문의 주장이 다른 경우 위 본문에 구분했다. 본문의 학습용 숫자와 예시는 실제 모델의 attention 관측값이 아니다.
- 책 5장 공개 개요 — Manning
- Vaswani et al., Attention Is All You Need, 2017 — 구조, attention 식, 학습 조건, 성능표. 도표 2·3의 원본. PDF 첫 페이지의 재사용 안내에 따라 출처를 명시했다.
- Rush, The Annotated Transformer, 2018 / 갱신된 해설 — 논문과 구현을 연결하는 자료.
- Bahdanau, Cho, Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, 2014 / ICLR 2015 — 고정 벡터 병목과 학습된 정렬.
- Vinyals, Fortunato, Jaitly, Pointer Networks, 2015 — 입력 위치를 출력하는 구조와 조합 과제 실험.
- Graves, Wayne, Danihelka, Neural Turing Machines, 2014 — 미분 가능한 외부 메모리.
- Vinyals, Bengio, Kudlur, Order Matters: Sequence to Sequence for Sets, 2015 / ICLR 2016 — 집합과 순서, Read–Process–Write.
- Sutskever, Vinyals, Le, Sequence to Sequence Learning with Neural Networks, 2014 — 입력 반전과 LSTM encoder–decoder.
- Dehghani et al., Universal Transformers, 2018 / ICLR 2019 — 깊이 방향 반복과 적응적 계산.
도표 1·4·5·6·7은 위 자료를 참고해 이 글을 위해 직접 구성하고 화면으로 캡처했다. 원 논문의 실험 그래프로 오인하지 않도록 개념도, 설명용 수치, 이론적 계산을 각각 표시했다.
질문 생각해보기
- Bahdanau attention은 무엇을 없앴고, 무엇은 남겼는가?
- Q·K·V 가운데 직접 가중합되는 것은 무엇인가?
- Cross-attention에서 Q와 K·V는 각각 어디에서 오는가?
- 훈련 때 정답 문장을 알고 있다면 왜 mask가 필요한가?
- 입력 길이가 두 배가 되면 무엇이 네 배가 되는가?
- Pointer Network와 보통의 attention은 어디에서 갈라지는가?
- 이 장을 ResNet과 한 문장으로 연결한다면?